AIの思考データの不正な抜き出しを9割以上阻止 Anthropicが新対策
- Anthropicは、Claudeの思考プロセスを無断で抜き取り模倣する蒸留攻撃を90〜99%削減したと発表した。
- 不正コピーは安全対策を欠いた危険なAIの拡散や安全保障上の脅威につながるため、3つの防御策を導入した。
- 不正アカウントの大量停止や誤検知率0.1%未満の検知器導入を進め、正規ユーザーへの影響も抑える。
米Anthropicは2026年10月12日、同社のAIモデル「Claude」に対する不正な「蒸留攻撃」を防ぐ新手法を導入し、攻撃者によって収集されるデータ量を約90〜99%削減したと発表した。蒸留攻撃とは、高性能なモデルに大量の問い合わせを行い、その応答を利用して別のモデルを訓練することで、開発時間と費用を大幅に抑えて能力を複製する行為を指す。
Anthropicは不正な蒸留を懸念する理由として、安全対策の欠落と国家安全保障上のリスクの2点を挙げている。十分な安全対策を伴わずに最前線の能力だけを模倣したモデルが作られると、生物兵器やサイバー攻撃に悪用される恐れがある。同社によると、中国のZhipuが開発した「GLM-5.3」は米国の先端モデルのサイバー能力を蒸留しており、安全対策を容易に回避できる状態にあるという。また、Moonshotの「Kimi」に関連した蒸留では、監視カメラ映像の個人分析を求めるリクエストがClaudeに密かに転送されていた事例も確認されている。
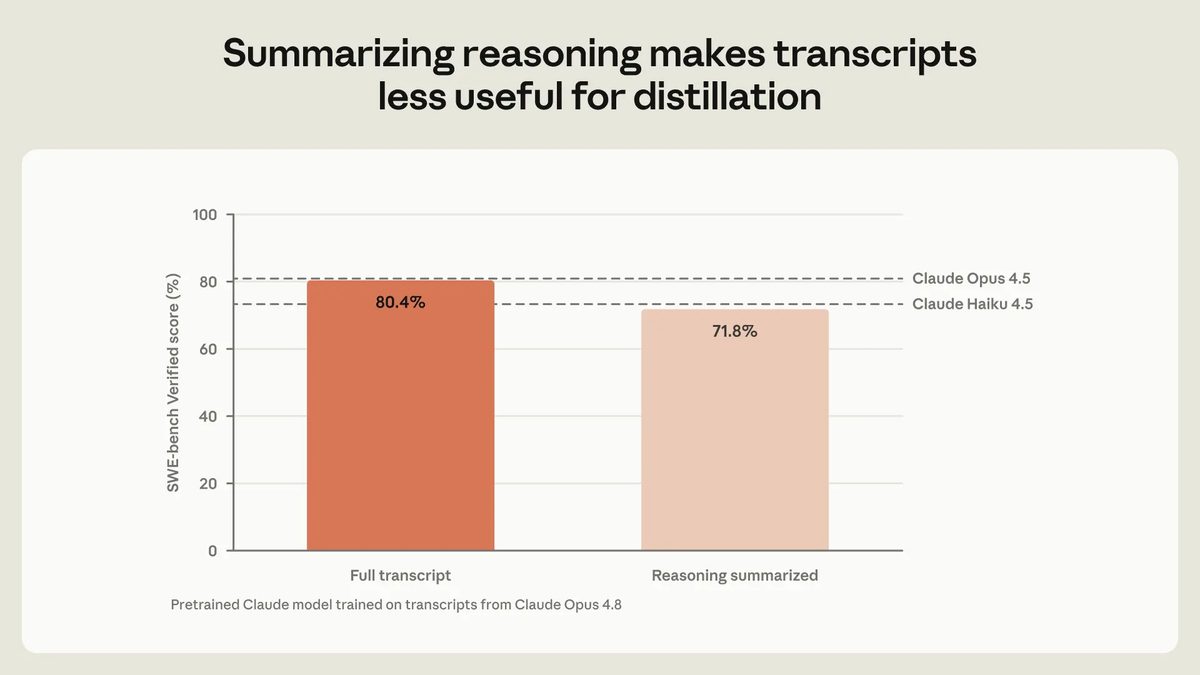
蒸留で最も狙われるのは、モデルが出力を生成する前に行う思考プロセスの記録である。Anthropicは当初、思考プロセスを要約して表示する対策を実施し、プログラミング評価の「SWE-bench Verified」において、完全な記録で学習したモデルが80.4%を記録したのに対し、要約データでは71.8%に低下することを確認した。しかし攻撃者は、Claudeに思考をそのまま出力させるプロンプトを試すなど手法を高度化させた。中には1万2,000通りのリクエストを試行した組織や、2万件以上の不正アカウントを束ねるプロキシネットワークを構築して回避を試みる組織も現れた。
これに対抗するため、同社は3つの防御策を導入した。第1に「preserved thinking」機能により、2026年8月31日以降に作成されたAPIアカウントが過去の文脈を編集することを防ぎ、思考データの不正な移動を制限した。第2に、生物兵器対策と同等に強固で誤検知率が0.1%未満の「2段階分類器」を導入し、抽出の試みを検知・遮断した。第3に、抽出を繰り返すアカウントの利用制限や停止を実施し、9月24日からは検知器によって遮断されたリクエストへの課金も再開した。
これらの対策により、プラットフォーム上で攻撃者に抽出された思考トークンの量は従来の10分の1から100分の1に減少した。また、蒸留に関与した数万件のアカウントを、攻撃開始から2時間未満で停止できるようになったとしている。同社は、蒸留対策は今後もいたちごっこが続くと予想されるとし、フロンティアモデルを開発するすべての企業やプラットフォームが協力して対策に取り組む必要があると訴えている。
この記事は Anthropic 公式の発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
