過去の失敗を教訓に自動で改善するAI、追加の学習なしで顧客対応テスト首位に
- AIが自らの試行記録から成功と失敗の行動指針を抽出し、指示文に追記する手法「ALTK-Evolve」が検証された。
- 顧客対応テストで過去世代のモデルを用いながら、追加の機械学習なしに小売部門の評価で首位の成績を記録した。
- 指示文の追加で会話回数は微減し応答速度も改善した一方、入力文字数の増加による費用増は生じるとしている。
AIエージェントが過去の試行経験から自律的に行動指針を導き出して指示文(プロンプト)に反映させる手法「ALTK-Evolve」により、モデルの学習済みのAIに自社データなどを追加で学ばせて、特定の用途に合わせて調整すること。">追加学習を行わずに顧客対応向け性能評価でトップ成績を収めたとする検証結果が公表された。
顧客対応の自動化では、業務規程の遵守や適切なツールの実行が求められる。特定領域のデータでモデル自体を微調整する従来手法は費用がかさむうえに別の業務への応用が難しく、挙動が不安定になりやすい課題があった。開発陣は過去の取り組みで同アプローチをプログラム作成支援エージェントで検証していたが、今回は業務規則の遵守が厳格に問われる顧客対応分野での有効性を試した。
検証には、米Sierraが開発した顧客対応ベンチマーク「τ²-bench」の小売および航空分野が使われた。同テストはLLMが模擬顧客役を務め、データベースの最終状態が期待通りに更新されたか否かを判定する仕組みである。ALTK-Evolveは、エージェント自身の訓練タスクでの成功や失敗の試行履歴を分析し、本人確認や返品処理の手順といった短い行動規則に要約する。この規則群をシステムプロンプトの末尾に一覧として追加するだけで、エージェントの基盤モデルの重み更新や人手による注記作業は行わない。
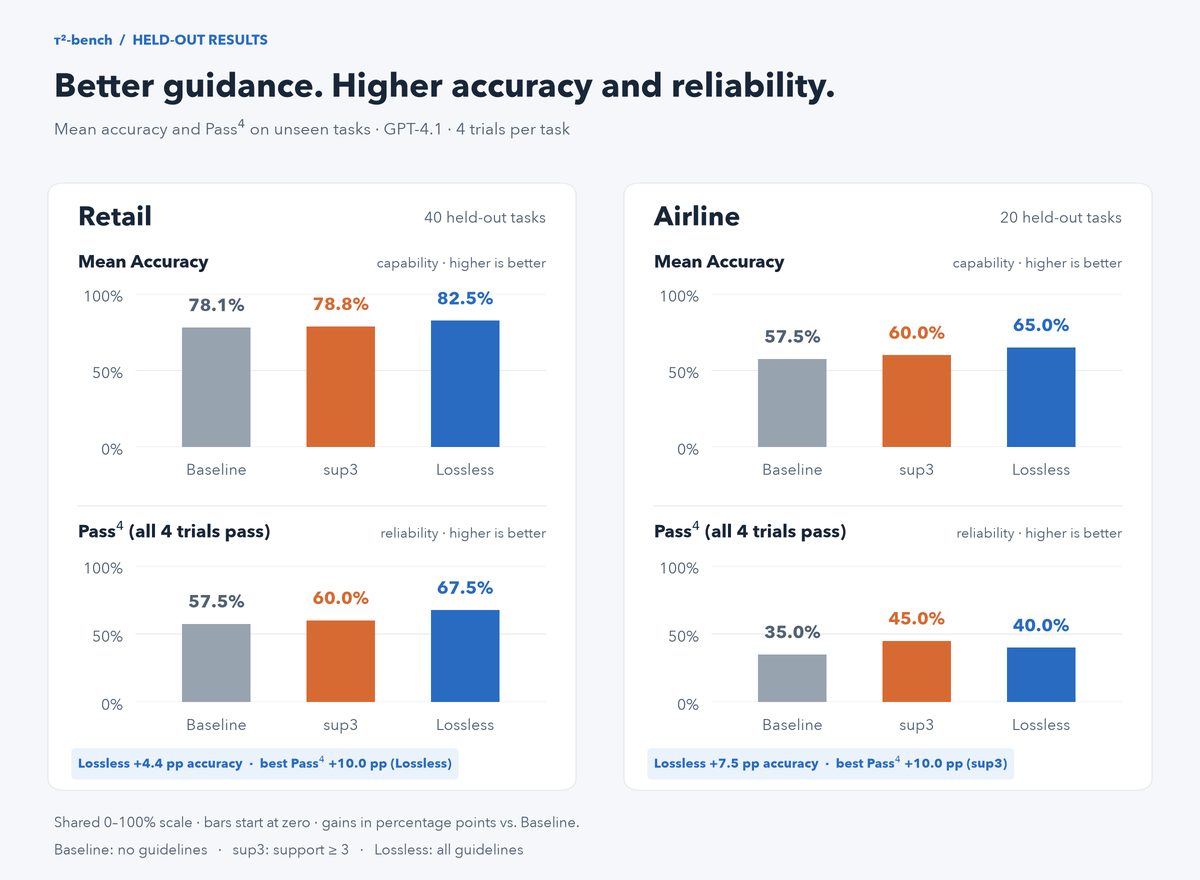
2026年10月12日時点のリーダーボード記録との比較において、推論特化型ではない従来モデル「GPT-4.1」を用いた基本構成のエージェントは、τ²-benchの小売部門で4回連続成功率(Pass^4)が67.5%に達した。これは専用データで微調整された競合モデル「RAFT-30B-A3B」の61.4%を6.1ポイント上回り、当時の全提出システムの中で首位の成績となった。また、航空分野で最新基盤モデル「GPT-5.5」に同様の手法を適用した実験でもPass^4が82.0%に達し、同分野で首位を記録した。
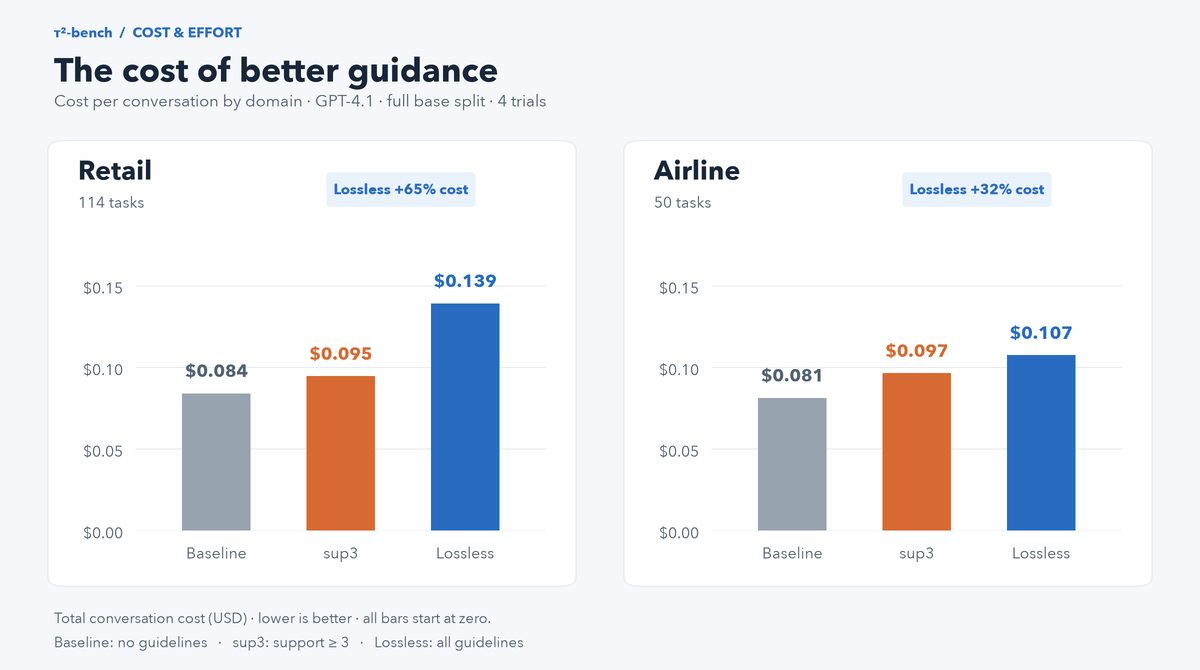
行動規則の追加により、同一条件で解決された対話のやりとり回数は小売で10.59回から10.16回、航空で9.15回から8.82回へとわずかに減少した。対話回数の減少は応答待ち時間の短縮につながる。一方でプロンプトの入力文字数が増えるため、小売タスクでの1会話あたりの計算費用は約0.084ドルから約0.139ドルに上昇した。ただし、固定の指示文ブロックはプロンプトキャッシュ機能で実運用上の費用を抑えられると分析されている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
