会話が長くなっても動作が重くならないAI、AWSの独自チップで高速処理に成功
- 従来のAIは会話が長くなると記憶用メモリが膨らむが、i14のモデルは容量を一定に維持できる。
- AWSのAI半導体向けに処理を改良し、1台の機器で毎秒約12万語の学習速度を記録した。
- 推論でも1,280件の同時処理で毎秒1万語以上を処理し、長文時のコスト増加を抑制した。
米アマゾン・ウェブ・サービス(AWS)とAI技術企業の米i14は、文章が長くなっても計算用メモリが増大しない学習し、次に来る確率の高い単語を予測して文章の理解や作成を行うAIの仕組みのこと。">言語モデル「Laplace 3B」を、AWSのAI半導体「Trainium2」上で学習・運用させる技術検証の成果を発表した。「trn2.48xlarge」インスタンス1台を用い、学習時に毎秒約12万トークン、推論時に1,280の同時接続で毎秒1万1,544トークンの処理速度を記録した。
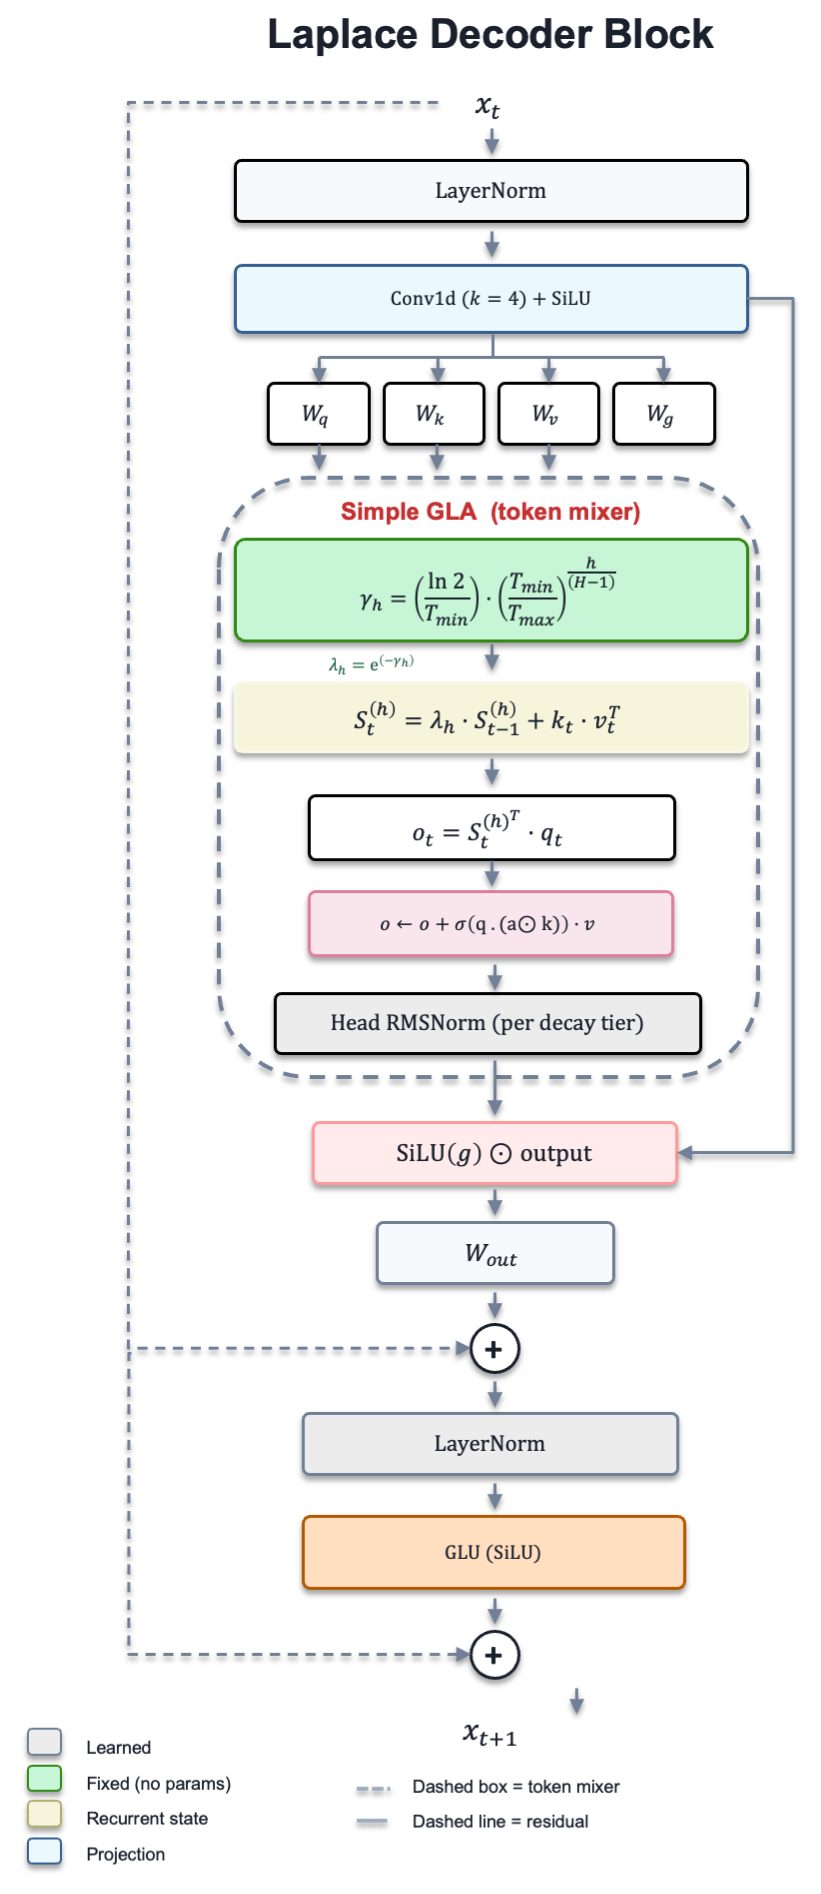
一般的な大規模言語モデルは、文脈が長くなるにつれて過去の情報を保持するメモリ領域が肥大化し、運用コストの増加や並列処理数の低下を招く課題がある。これに対し、約27億1,800万のパラメータを持つLaplace 3Bは、過去の文脈を固定サイズの行列に圧縮する線形アテンション機構を採用している。文脈長に依存せずメモリ状態を1系列あたり29.5メガバイトに抑えることができ、8,192トークン処理時の通常方式と比較して約82分の1のデータ量に削減できる。
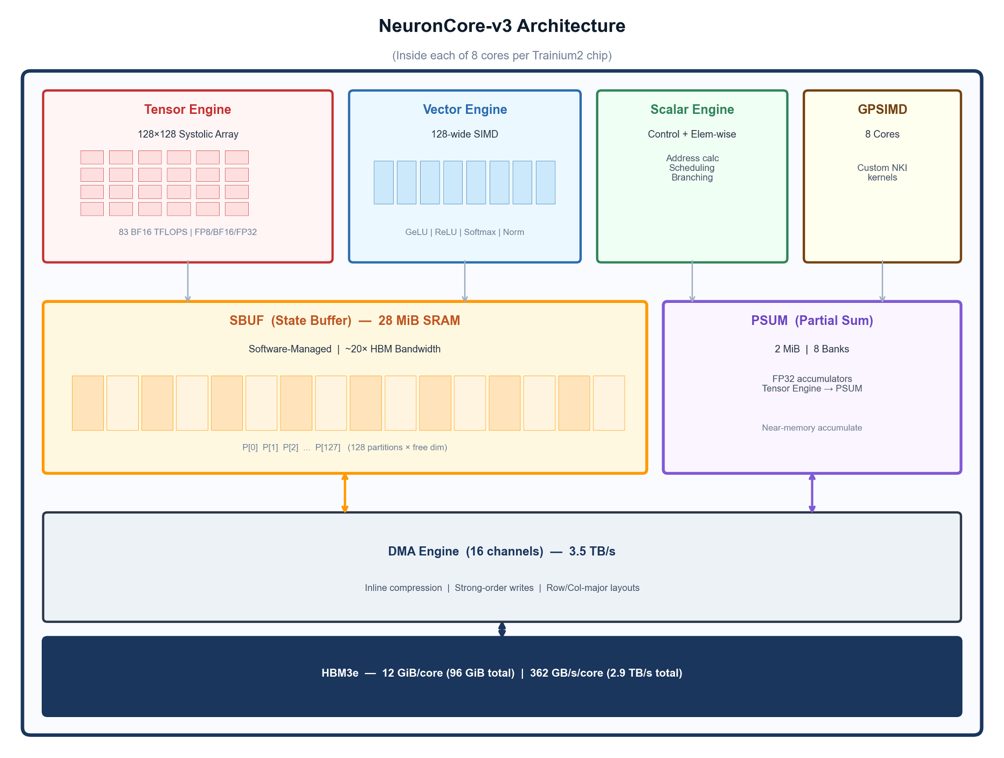
元々はGPU向けに開発されていたモデルだが、AWSの技術チームが標準的なPyTorchの演算処理へ書き換えた。チップ内部のメモリ構造に合わせてデータを128トークン単位で区切って並列処理する形に適合させたほか、学習用アルゴリズム「Muon」の通信手法を全ノード間通信へと再設計した。これにより、ノードごとの通信量を従来の10.87ギガバイトから24分の1となる0.45ギガバイトへ圧縮し、処理効率を1.63倍に引き上げた。
64基の論理コアを用いた学習実験では、約440億トークンを消化した時点で損失値が11.4から2.3729へと順調に低下し、処理速度も毎秒約12万トークンを維持した。推論テストにおいても毎秒1万1,544トークンを達成し、入力文を2,048トークンから8,192トークンに増やした場合のコスト増はわずか0.5パーセントにとどまった。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
