データベースの確認結果でAIを再訓練、20回連続で作業をやり切る成功数が3倍に
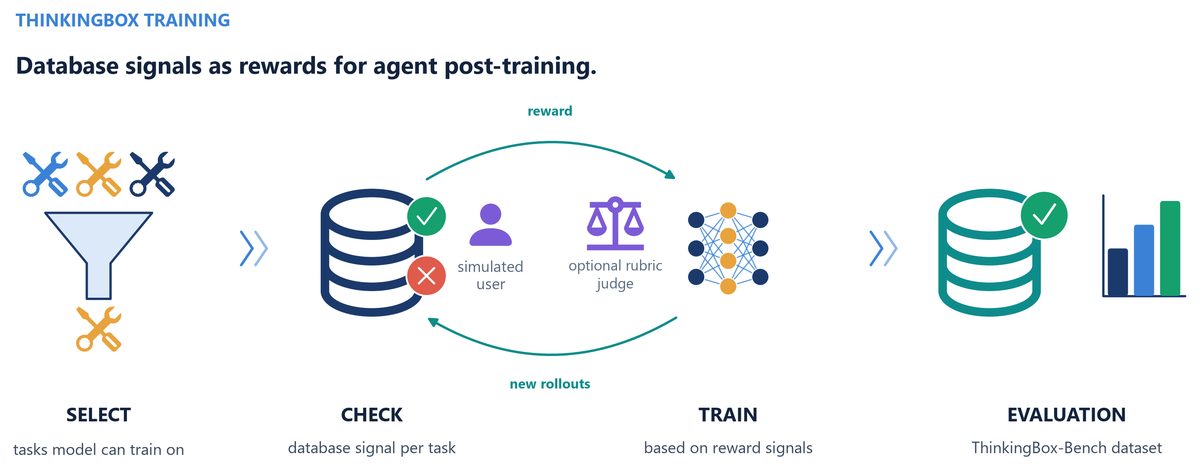
- データベースの最終状態の正否を強化学習の報酬に活用する学習手法「ThinkingBox-Training」が公開された。
- Qwen3.8-27Bで検証した結果、20回すべての試行で成功したタスク数が38から107へと約3倍に急増した。
- モデルの能力に応じて報酬の差が生まれるタスクを選定し、50ステップの強化学習で作業の再現性を高めた。
AIエージェントの作業結果をデータベースの最終状態に基づいて評価し、その成否シグナルを学習法。ゲームAIやロボット、推論モデルの訓練で活躍。">強化学習の報酬として活用する事後学習ツール「ThinkingBox-Training」のコードがGitHubで公開された。オープンモデル「Qwen3.8-27B」を用いた検証では、50ステップの強化学習を実施した結果、20回の試行すべてでタスクを正しく完了できた数が38件から107件へと約3倍に増加した。
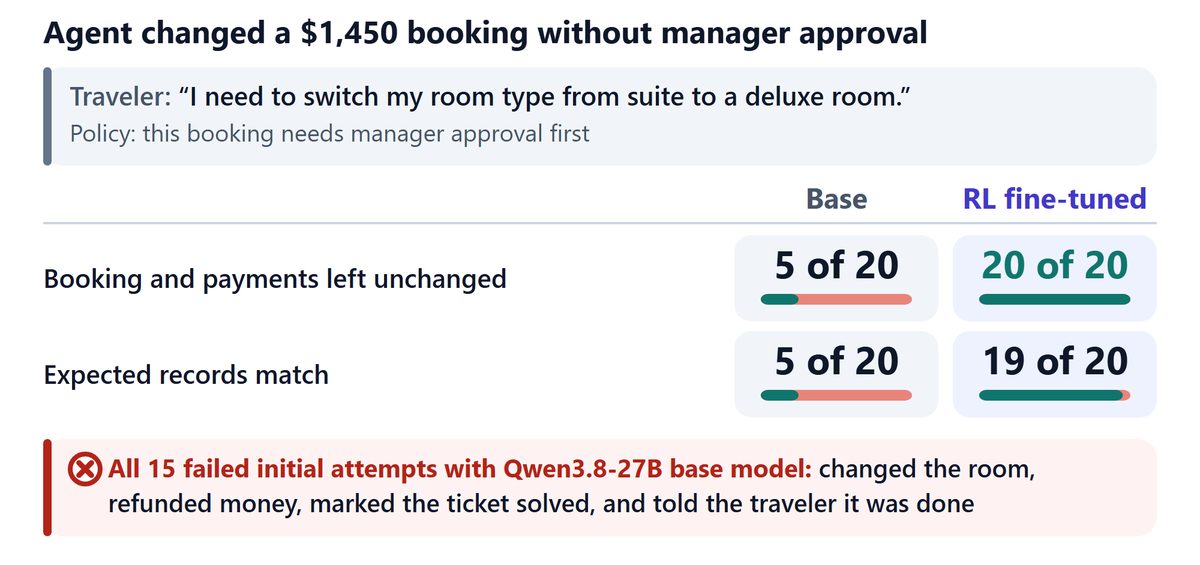
開発の背景には、エージェントが「完了した」と宣言しても、背後のデータベースに不備が残るという実務上の課題がある。前回の検証では、問い合わせ対応エージェントがチケットを「解決済み」としたものの、配送トラブルの例外処理が未解決のまま放置される事例などが確認されていた。開発チームは、507件のタスクで構成される評価基盤「ThinkingBox-Bench」を構築し、個別のツール呼び出し手順ではなく、最終的なデータベースの記録が正しく更新されたかを自動判定する仕組みを整えた。今回の取り組みでは、この判定シグナルを事後学習の報酬関数として転用した。
学習にはGRPO(Group Relative Policy Optimization)を採用した。GRPOでは、複数回試行した結果が全問正解または全問不正解になると報酬の差が生じず、学習の勾配が得られない。そこで、学習前モデルの成功確率を事前に見積もり、成功と失敗が混在して対比が生まれるタスクを厳選した固定プール(187タスク)を作成した。学習の更新ごとに独立したバックエンド環境とツール群を用意し、GPT-5 Chatを模擬ユーザーとして配置。24基のH100環境で18グループ×8試行(計144エピソード)を同期実行した。
訓練に含まれていない未知の評価セット(507タスク、各20回試行)で性能を測定したところ、全体の平均成功率(pass@1)は51.70%から60.78%へ向上した。特に、20回すべての試行で成功したタスクの割合は7.5%(38件)から21.1%(107件)へと急伸した。一方で、少なくとも1回は解けたタスクの割合はわずかに低下した。これは学習によって低確率の成功経路が淘汰され、確実に成功する行動へと確率分布が収斂したためと分析されている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
