自社デザインでスライドを作る小型AI、大手サービスに迫る総合2位
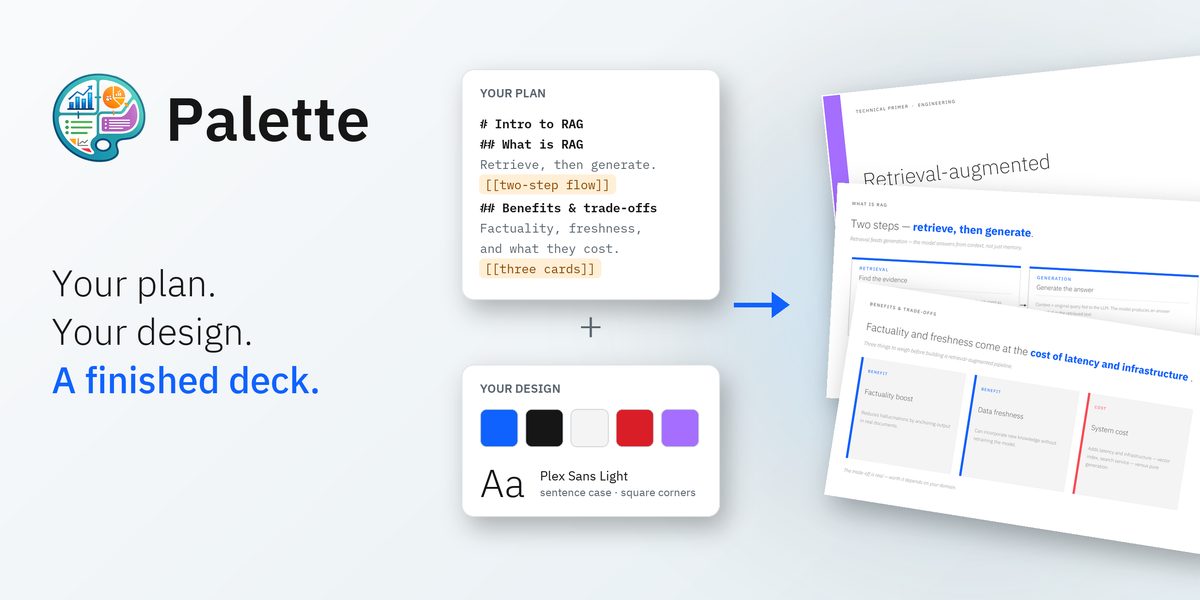
- 自社システムで動く小型AIにスライド作成を学習させる技術「Palette」の成果が公表された
- 構成の設計とコード作成を分担し、自動修復機能と組み合わせることで生成の乱れを解消した
- 性能検証では経済や教育分野で1位となり、3分野平均で大手サービスに次ぐ2位を記録した
自社環境で動く小型AIでスライド作成
Hugging Faceは、組織独自のデザイン方針に沿ったスライド資料を小型の公開モデルで生成する技術「Palette」に関する検証結果を発表した。外部の大規模商用モデルに頼らず、自前のインフラ上で稼働させられる200億(20B)学習で調整される膨大な数値。「7B」は70億個の意味で、多いほど賢くなる傾向があるが動かすコストも増える。">パラメータ規模のオープンモデルをファインチューニングし、表示崩れを防ぐ検査機構と組み合わせることで、大手システムに匹敵する精度を実現したとしている。
最先端の商用モデルは高品質な資料を作成できる一方で、モデル固有の様式に戻りやすく、利用企業が自社のテンプレートに厳密に従わせることが難しい。また、機密情報を含む資料ではデータを社外インフラに出せない制約もある。一方で、自社ホストが可能な小型モデルは、文字の背景への埋没やテキストのはみ出し、図形の重複など、配置計算の誤りによる表示崩れを頻繁に起こす点が課題となっていた。
設計とコード記述を分離し並列処理
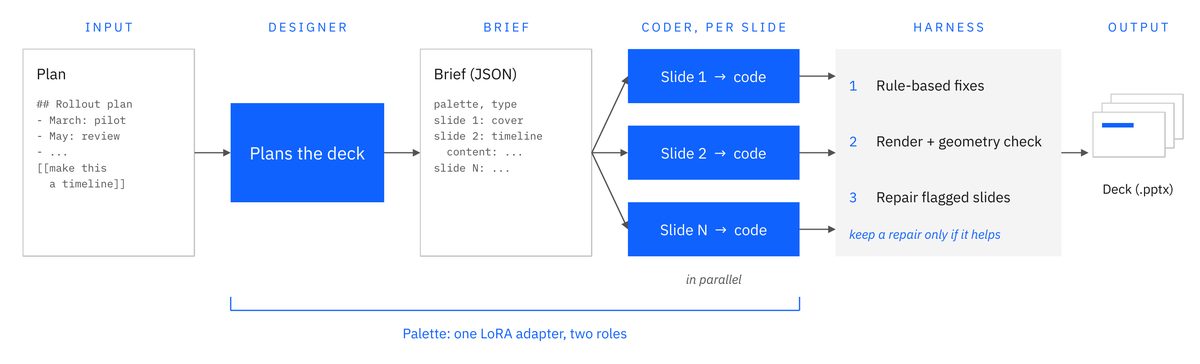
Paletteでは、人間が資料を作成する工程を踏襲し、役割を「設計者」と「コーダー」に分割した。設計者役が全体の構成やレイアウト、デザインの意図を記した指示書(ブリーフ)をJSON形式で作成し、コーダー役がその仕様に基づいてスライド描画用のJavaScriptコード(pptxgenjs)を記述する。この2つの役割は単一のLoRAアダプターで実装されており、スライドごとのコード生成を並列で処理することで、コーディング段階を約6〜7倍高速化した。
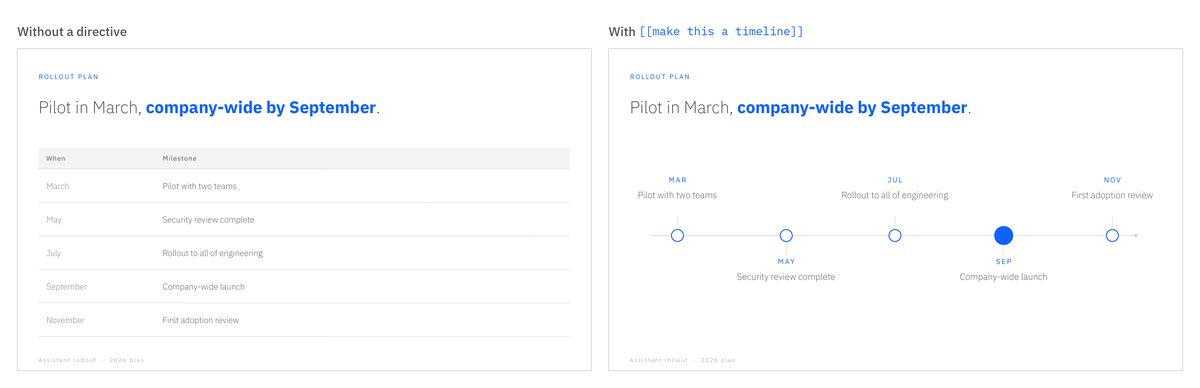
学習用には、IBM Design Languageに準拠した約1,000件(約1万スライド分)の合成データを作成した。各事例には、採用しなかった代替レイアウトの理由も反実仮想的な思考ログとして記録し、デザイン判断の規則を学習させている。また、指示文を二重括弧で囲むことで、年表の生成や配色の変更などを細かく指定できる機能も組み込んだ。
検査機構で崩れを修正し高精度を達成
生成されたスライドは直接出力せず、専用の検査基盤(ハーネス)を経由する。チェッカーが表示崩れを検知した場合は別の編集モデルがコードを修正し、改善が確認された場合のみ修正版を採用する仕組みとした。131件のスライド資料を用いた測定では、この検査基盤によってスコアが平均3.5ポイント向上した。
評価指標「PresentBench」での検証では、経済と教育の2分野で1位、講演分野で3位を獲得した。3分野の平均スコアは59.7を記録し、NotebookLMの60.8に次ぐ全体2位の数値を達成した。
今後は、検査基盤による判定信号をGRPO方式などの強化学習における報酬として活用し、生成段階での誤りを防ぐ取り組みを進める。さらに元文書から図表を抽出して配置する機能の追加や、モデルを再学習させずに既存のPowerPointファイルからデザインを適用する手法の検証も進める予定だ。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
