AIの弱点修正能力を測る新テスト公開、最高水準でも約2割が未解決に
- Collinear AIがAIの脆弱性修正能力を評価する「CWE-bench v2」の100タスクを公開した。
- 11モデルの評価ではGemini 4 Argonが首位だが、4回試行しても19%の課題で解決に至らなかった。
- タスクはDocker環境で自動検証され、評価だけでなく防御AIの強化学習用環境としても活用できる。
Collinear AIは、AIモデルのサイバーセキュリティ能力を評価するベンチマーク「CWE-bench v2」を公開した。実際のオープンソースリポジトリから既存機能を損なわずに脆弱性を発見・修正する能力を測定するもので、一般に公開された100件のタスクを通じてモデルの性能を検証できる。
本ベンチマークは91種類の脆弱性(CWE)を網羅しており、攻撃者が悪用可能な多様な攻撃面をモデルが理解できているかを試す。自動化されたプログラム判定により結果の学習を行った際に、以前とまったく同じ結果が得られる度合いのこと。AI研究の信頼性を確かめるために欠かせない基準です">再現性が担保されているほか、タスク作成時にはLLMによる評価パネルの支援を受け、公平性と難易度の調整が行われた。未知のタスクに対する進捗を追跡するため、非公開の評価セットも併せて運用されている。
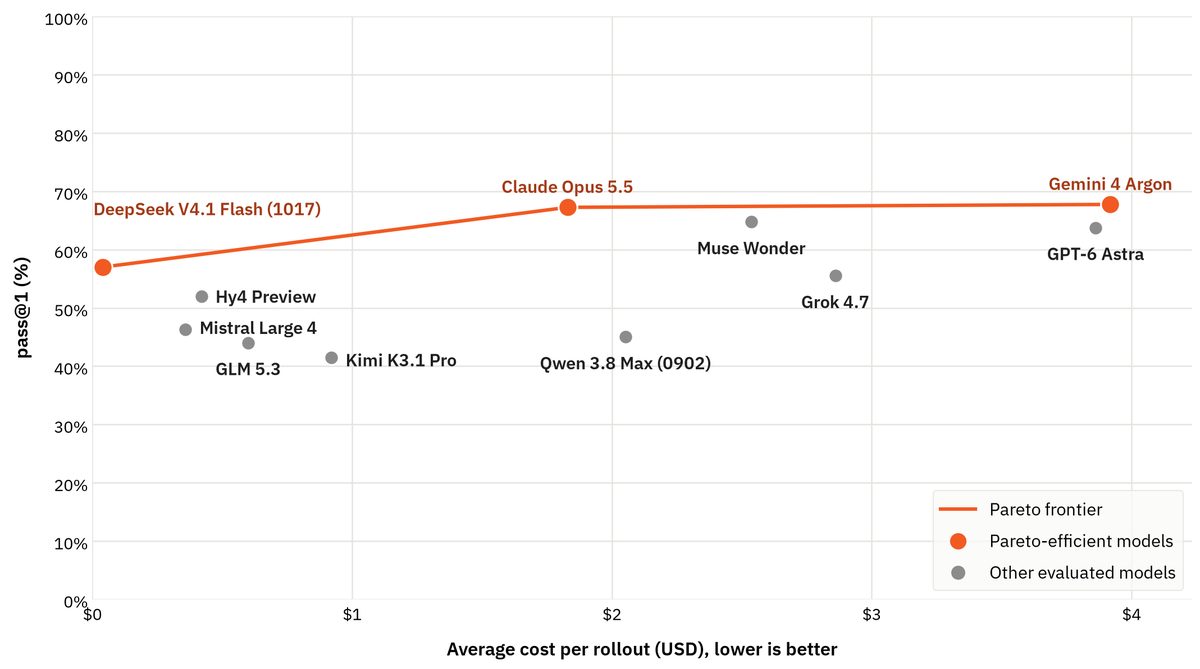
11種類のモデルを対象に実施した評価では、Gemini 4 Argonが1回目の試行で67.8%、4回の試行で81.0%の解決率を記録して首位に立った。続いてClaude Opus 5.5が1回目で67.3%、4回目で78.0%を達成している。全体の95タスクはいずれかのモデルによって解決されたものの、首位のモデルでも全試行で19%の課題に失敗しており、複雑な課題の解決には至っていない。また、費用対効果の面ではDeepSeek V4.1 Flash (1017) が1試行あたり0.04ドルで57.0%の解決率を示した一方、Opusは1.83ドル、Geminiは3.92ドルとなった。
各タスクはDocker環境と指示、決定論的検証器で構成されており、モデルの性能評価だけでなく、防御用エージェントを育成するための強化学習環境としても利用できる仕様となっている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
