数日かかったAI改修がゼロに!? アマゾンが明かした社内データ連携の舞台裏
- アマゾンが北米物流拠点の計画業務向けに、対話型AIで社内データを検索・集計できる基盤をAWS上に構築した。
- 従来はデータ追加に数日の開発を要していたが、設定ファイルを置くだけで自動認識する仕組みで個別開発を不要にした。
- テスト検証では質問から回答まで15〜20秒で完了し、複数のAIから同じ窓口を通じて安全に照会できる。
社内の膨大なデータにAIをつなぎ、対話形式で自由に集計・検索させる――。言葉にするのは簡単だが、現場のエンジニアなら「そんなに甘くない」と首を振るはずだ。データの追加やスキーマ変更があるたびに改修作業で数日潰れるのが日常茶飯事だからである。ところが米アマゾンが「設定ファイルを置くだけで個別開発は不要、15〜20秒で即答できる」という夢のような基盤を構築したと発表した。いくらテック巨人とはいえ、話がうますぎるのではないか?
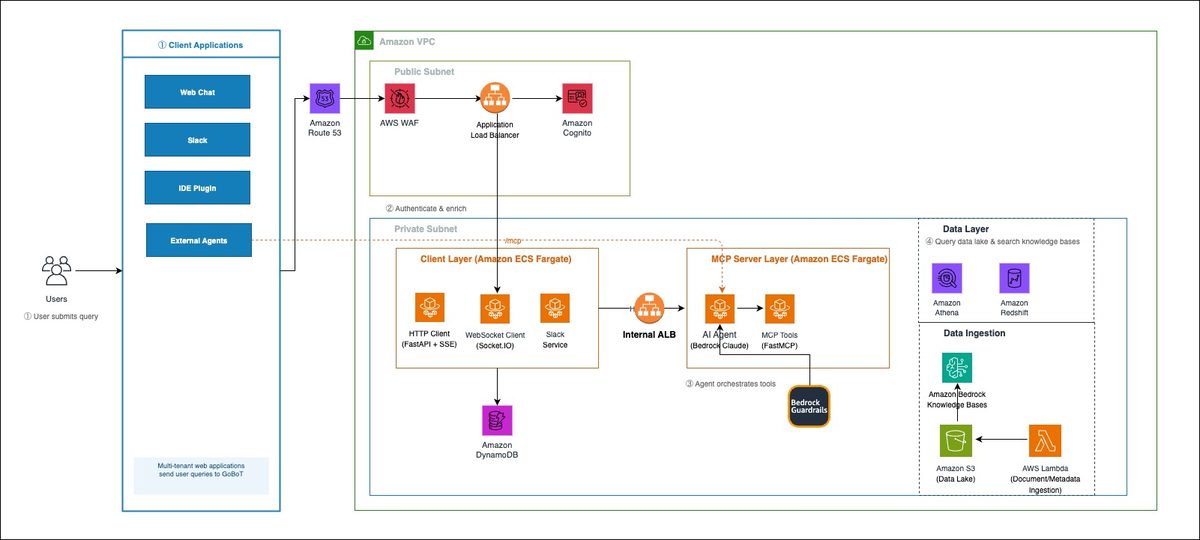
同社技術チームが公開した一次情報によれば、舞台となったのは北米の仕分け拠点網(NASC)だ。輸送容量や荷物の流れを管理する数千規模のデータセットに対し、従来は部門ごとにAIアシスタントを個別開発していたため、テーブルへの接続ごとに数日を要していた。これを打破すべく同チームは、共通接続規格「MCP」に準拠したサーバーレス基盤を構築。新データの追加時は、構造や意味を記述したJSONファイルを置くだけでベクトル) に変換すること。検索や重複判定、RAGの土台になる。">ベクトル化され、プログラムの再配備やサーバー再起動なしに全AIから利用可能になるという。検証では質問入力から読み取り専用SQLの自動生成・実行、回答までがわずか15〜20秒で完了した。
ここからは編集部の推測だが、アマゾンが直面していた真のボトルネックは、データ接続そのものよりも「部門ごとの重複開発とセキュリティ統制の形骸化」だったのではないか。物流の運用データが数千規模に膨らむなか、個別改修を続けていては現場のエンジニアが疲弊するのは目に見えている。共通プロトコルのMCPを盾にしてAIとデータを疎結合にし、安全管理やSQL生成を基盤側に集約させたのは、全社的なガバナンス崩壊を未然に防ぐための必然の防衛策だったとみるのが自然だろう。
確かと言えるのは、メタデータファイルを配置するだけで個別開発を挟まずに即座にAI検索へ組み込める仕組みが、AWS上で実用段階に達したという事実だ。一方で、実際の現場で飛び交う多様で曖昧な業務指示に対し、AIがどこまで誤読なく的確なSQLを生成し続けられるのか、その長期的・大規模な運用実績についてはまだ検証の余地が残る。社内データ活用の壁を打ち破る一手となるのか、今後の展開に注目したい。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
