1時間の音声を13秒で文字起こし 外部送信なしで動く新技術が公開
要点 3行
- Googleの埋め込みモデルを転用し、端末内で音声を高速に文字起こしする実験結果が公開された
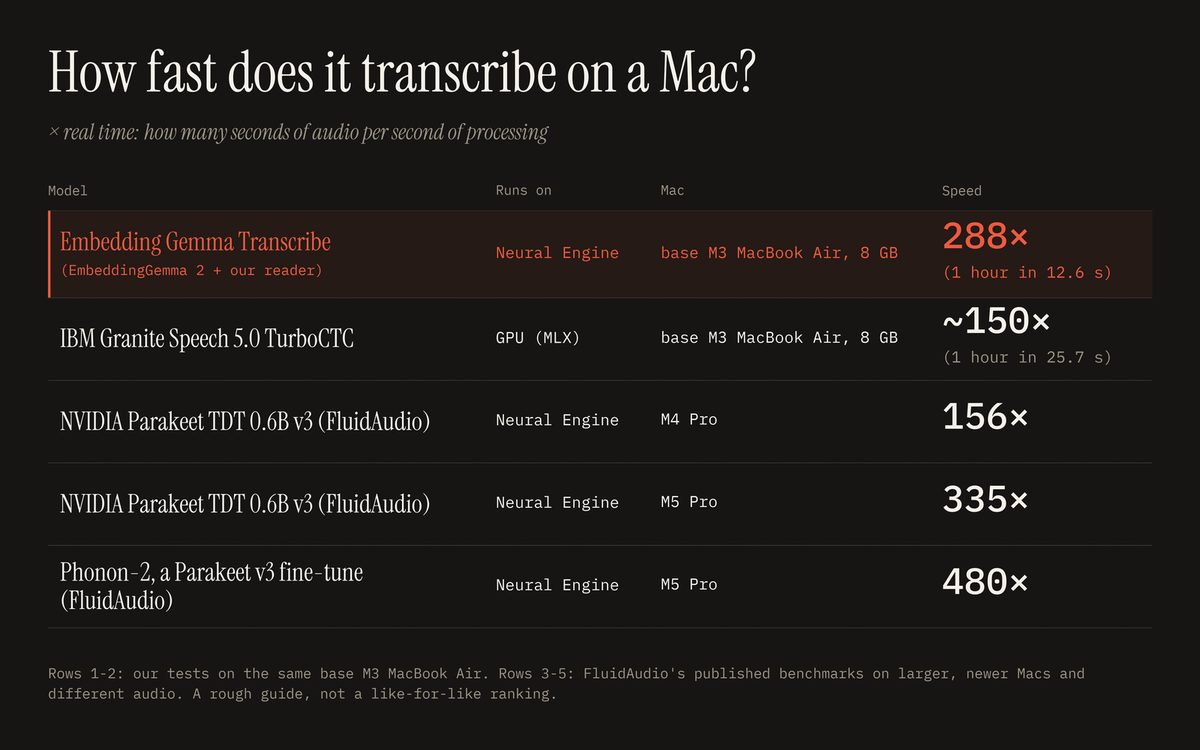
- 1時間の音声を約13秒で処理し、通信を介さずパソコン内部だけで安全に動作するのが特徴だ
- 単語誤り率は約5%で、わずか2時間足らずの追加学習により実現した手法の仕組みも明かされた
Googleのマルチモーダル埋め込みモデル「EmbeddingGemma 2」を音声認識へと転用し、MacBook Air上で1時間の音声を約13秒で文字起こしする検証結果が公開された。音声データは端末外へ送信されず、すべてオンデバイスで処理される。
EmbeddingGemma 2は元来、テキストや画像、音声などを同一の空間上で扱うモデルであり、音声認識向けの学習は施されていない。今回の取り組みでは、既存の音声エンコーダーをそのまま維持し、短い音声区画をテキスト空間へ対応づける軽量な読み取り機構を追加した。約22万9000語の英単語から最も近い語を選び出して書き起こし、さらに別の小型モデルで句読点や大文字の補正を行う。学習はオープンライセンスの英語音声を用い、8基のH100で2時間未満で完了したという。
単語誤り率は主要モデルの2〜3%に対して約5%にとどまるが、読み取り機構の改善によって差を縮められると見込んでいる。
この記事は eg2.haku.shの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開くアプリなら毎朝1件、注目のAIニュースが届きます
記事中の専門用語をタップすると、その場で辞典の解説が開きます。無料・広告のみ。

