GENSHI AI、日本の医療に即した問答100万件を無料公開 世界最大規模
- GENSHI AIが、100万件超の日本語医療QAデータセット「GENSHI-MedQA-1M」を非商用向けに無償公開した。
- 独自収集した医療文書約18万ページのうち2010年以降の情報から生成AIで合成し、国内の診療実態を反映した。
- 公開済みの日本語テキスト医療QAとして最大規模で、誤り修正や改訂を続けながら自社製品開発にも活用する。
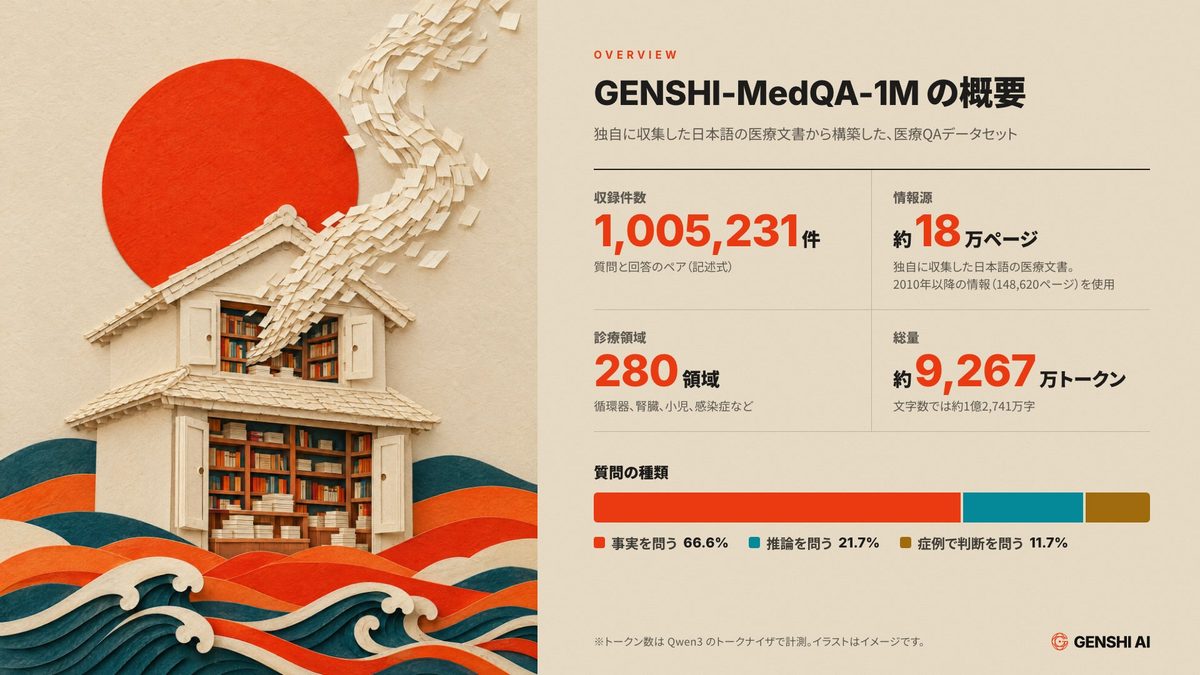
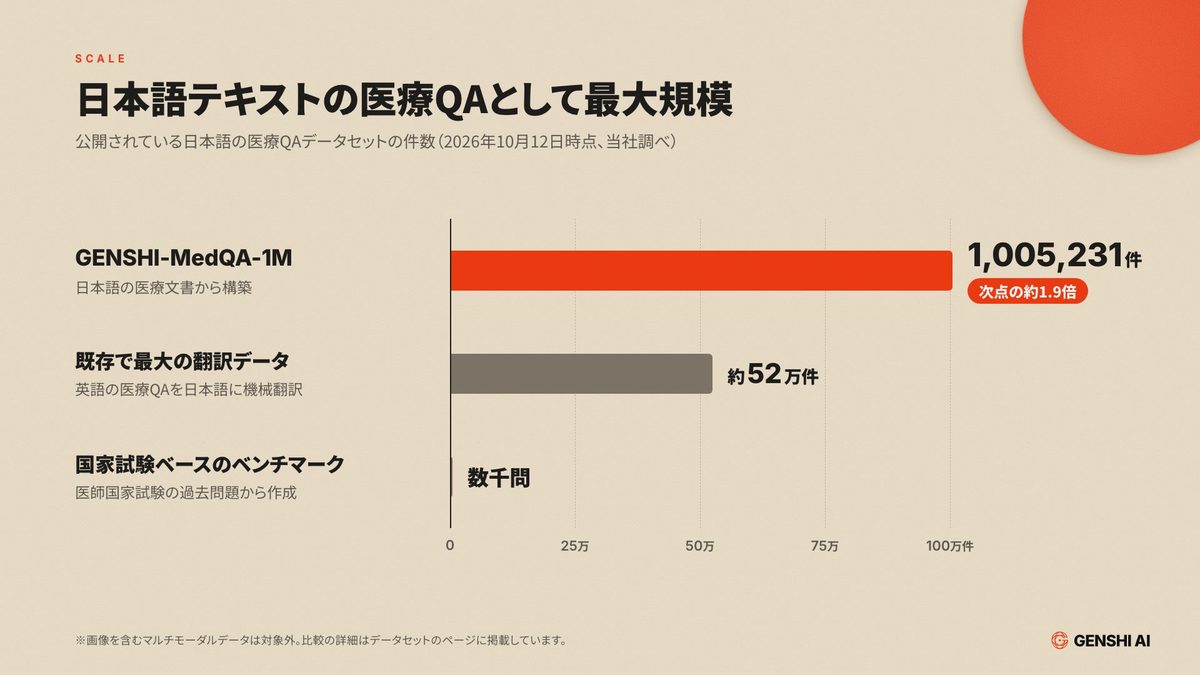
株式会社GENSHI AIは、日本語の医療QA学習や分析を行うために、特定の目的に沿って集められ、使いやすく整理されたデータのまとまりのこと。文章や画像、音声など様々な形式があります。">データセット「GENSHI-MedQA-1M」を公開した。独自に収集した日本語医療文書をもとに構築した100万5,231件の質問と回答からなり、公開されている日本語テキストの医療QAデータセットとして最大規模になるという(2026年10月12日時点、同社調べ)。非商用の研究目的に限り無償で提供する。
大規模言語モデル(LLM)を医療分野で活用するには、日本の診療に即した知識を日本語で学習させる必要がある。しかし、従来の日本語データセットは医師国家試験の過去問による数千問規模のものや、英語データの機械翻訳が中心だった。機械翻訳の最大規模データ(約52万件)でも、日本の保険適用や医薬品の承認状況、国内の診療慣行に関する情報が欠落する課題があり、日本語原文から作成した学習データが求められていた。
GENSHI-MedQA-1Mは、独自収集した日本語医療文書17万9,479ページのうち、2010年以降の14万8,620ページをもとに生成AIで質問と回答を合成した。質問の種類は、事実を問う質問が66.6%、推論を問う質問が21.7%、症例を示して判断を問う質問が11.7%で構成され、病態生理や治療選択の根拠まで記述式で収録している。英語の「medical-o1-reasoning-SFT」を「GPT-4o-mini」で翻訳した既存の最大データセット(約52万件)と比較して約1.9倍の規模となる。
データセットはHugging Face経由で申請・承認を経て提供され、ライセンスは「CC BY-NC-SA 4.0」が適用される。営利目的のモデル学習を含む商用利用や、診断・治療の判断、患者への助言への使用は禁止されている。
同社は「日本語で医療AIをつくろうとすると、最初に突き当たるのが学習データの壁」「日本の医療AI研究が一段前に進むきっかけになればうれしく思います」と表明した。今後は研究者の意見をもとに誤りの修正や改訂を進めるとともに、閉域LLM基盤「MedLocal」など自社開発へ活用し、大学や医療機関との共同研究も受け付けるとしている。
この記事は PR TIMESの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
