100言語のAI翻訳を徹底比較 修正手順の追加で合格率が6割向上と判明
- Intentoが57種のモデルによる229のAI翻訳構成を100言語で検証した報告書を公表した。
- 高度な品質要件を満たす構成は12言語にとどまり、リアルタイムの一括処理では基準達成が困難だった。
- 品質不足のモデルでも、翻訳後に評価と修正の工程を重ねることで60%が品質基準を満たすと分析した。
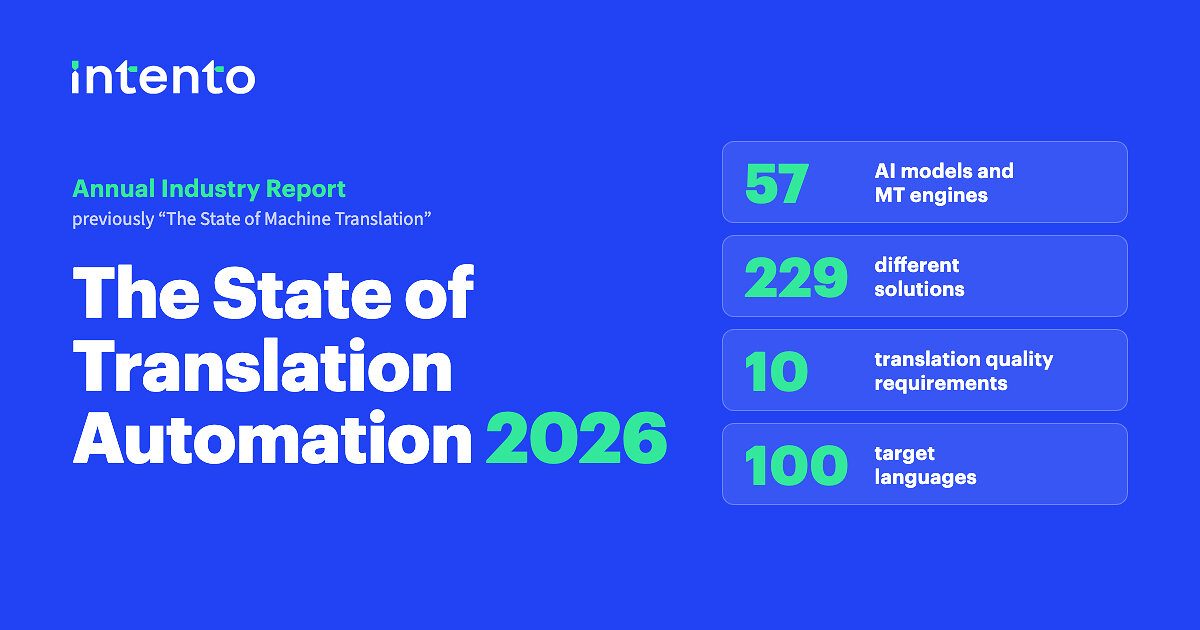
米Intentoは2026年10月16日、100言語を対象にAI翻訳の品質や費用、処理時間を比較検証した調査報告書「The State of Translation Automation 2026」を公開した。37社のベンダーが提供する57種類のAIモデルや機械翻訳エンジンを組み合わせた229のソリューションを評価し、利用者が求める要件や言語ごとに最適な構成を調べられる仕組みとなっている。
同社の共同創業者兼最高経営責任者(CEO)であるKonstantin Savenkov氏は、「これまでの翻訳自動化は、コンテンツや言語の組み合わせに対して『より誤りが少ない』モデルを選ぶことを意味していた。しかし現在は、翻訳要件を満たす周辺環境(ハーネス)をモデルの周囲に構築することが求められている」と指摘している。報告書では、既製モデルから開始し、要件を満たせない場合にのみ手順を追加する実践的な手法を採用した。
評価対象となった57モデルには、Alibaba、Amazon、Anthropic、Cohere、DeepL、DeepSeek、Google、Microsoft、Mistral、OpenAI、Tencent、xAIなどのニューラル機械翻訳や大規模言語モデルが含まれる。2026年6月から9月にかけ、記事や法的文書など計2,978語の英文を100言語へ翻訳した。品質は「Basic」「Standard」「Advanced」の3水準・10要件で測定し、3社の言語モデルによる審査員が文の90%以上で合意した結果を採用している。
検証の結果、翻訳の要求水準が高くなるほど、単一の処理手順で要件を満たせる言語は減少した。Basic水準では100言語中54言語が対応したものの、Standard水準では38言語、ジェンダー中立性を含むAdvanced水準では12言語にまで落ち込んだ。また、18言語では自動評価の信頼性が不足していた。
一方で、モデル単体では要件を満たせない場合でも、追加の工程を組み込むことで品質が大きく改善することが確認された。初期状態で基準に届かなかったモデルも、翻訳後の事後編集を加えることで24%、品質評価とエラー修正の工程を追加することで60%が一般的な品質要件を達成した。なお、84言語で検証されたリアルタイムの単一ステップ翻訳では、Standard水準の全要件を満たせるものは存在せず、達成できた38言語でも最速の構成で1,000語あたり中央値約65秒を要した。
Intentoは60社以上のグローバル企業向けにAI翻訳の自動化基盤を展開しており、今回の報告書は登録不要で同社ウェブサイト上で閲覧できるとしている。
この記事は PR Newswire (AI)の発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
