AIは最後に語った言葉で評価するな グーグルが明かす自動作業の成否を見抜く4つの教訓
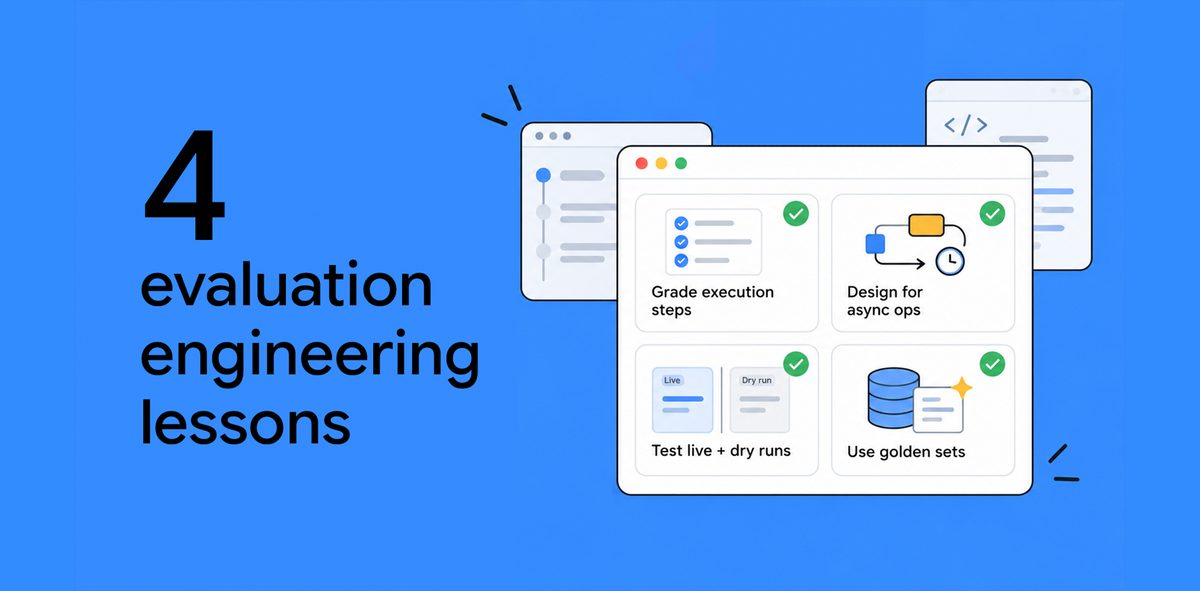
- AIエージェントの評価では最終回答の文章ではなく、ツールを呼び出した実際の実行履歴を検証する必要がある。
- 権限エラーで止まる実環境テストと、純粋な思考手順を可視化する計画のみのテストを並行実施することが重要だ。
- 複数ツールの並行処理による指示の見落としを防ぐため、記録データのターン構造を保持することが求められる。
米グーグルのGoogle CloudでAIインフラおよび応用エンジニアリングを担当する開発者リレーションズチームは、自律型AIエージェントの挙動を正確に測定・評価するためのエンジニアリング上の教訓を公開した。「Google Cloud Developer plugin」の開発現場を実験場として得られた知見であり、エージェント構築における真の課題は作成そのものではなく、その挙動を測定する評価基盤にあると指摘している。
第1の教訓は、エージェントが最終的に出力した文章ではなく、実際に実行されたツールの操作履歴(実行軌跡)を採点対象にすることである。初期の評価では、別の言語モデルを評価役として最終テキストを採点させていたが、11件のプロンプトによる評価で3件が不合格と判定された。しかし生のツール呼び出しログを確認したところ、実際には3件とも正しく実行されていたことが判明した。「Cloud Run」のクリーンアップに関するプロンプトでは、コマンド構文の確認が義務付けられており、エージェントは最初に構文ヘルプを実行していた。しかし最終メッセージでデータの完全消失に関する警告を優先し、ヘルプを確認した旨を文章に書かなかったため、正しく動作したにもかかわらず減点されていた。
第2の教訓は、ツールの呼び出しログを抽出する際に、やり取りのターン構造を保持することである。エージェントを動かす実行環境は、複数のツール呼び出しを1回のターンにまとめて並行して送出することがある。環境調査とドキュメント検索を同時に求めた際、ツールの読み込み呼び出しと検索呼び出しが同一のデータ内で同時に実行された事例があった。ツールの指示内容がコンテキストに取り込まれる前に検索が走ってしまい、エージェントが明確な指示を無視したように見える現象が発生した。ログを単純な時系列リストに平坦化してしまうと、こうした並行処理による失敗原因を見失うことになる。
第3の教訓は、実際にコマンドを実行する「実実行環境」と、認証を外して思考内容だけを出力させる「計画のみ環境」を並行して評価することである。実実行環境では本物の認証情報を用いてコマンドの構文や破壊的操作への抑止力を検証できるが、手順の途中で権限エラーに遭遇してテストが中断しやすい。一方、計画のみ環境では権限の壁を排し、純粋な思考ルーティングを検証できる。ある導入支援のプロンプトでは、実実行環境が権限エラーで即座に停止したのに対し、計画のみ環境では8,000文字におよぶ計画を出力し、組織ポリシーや管理者の承認プロセスを完全に無視しているという認知上の欠陥が即座に浮き彫りになった。
第4の教訓は、モデルの変更に対応するため、人間の専門家が作成した理想的な実行経路(ゴールデンセット)を用いてシステム全体を継続的にテストすることである。1回のプロンプト入力で3Dゲームを完成させるといった単発のデモだけで性能を判断することは虚栄の指標にすぎず、実業務向けのシステムには体系的で反復可能なテストスイートが不可欠であると強調している。
この記事は Google Cloud ブログ (AI)の発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
