NVIDIA、追加学習なしで業務データを高精度に予測できる新AIを公開
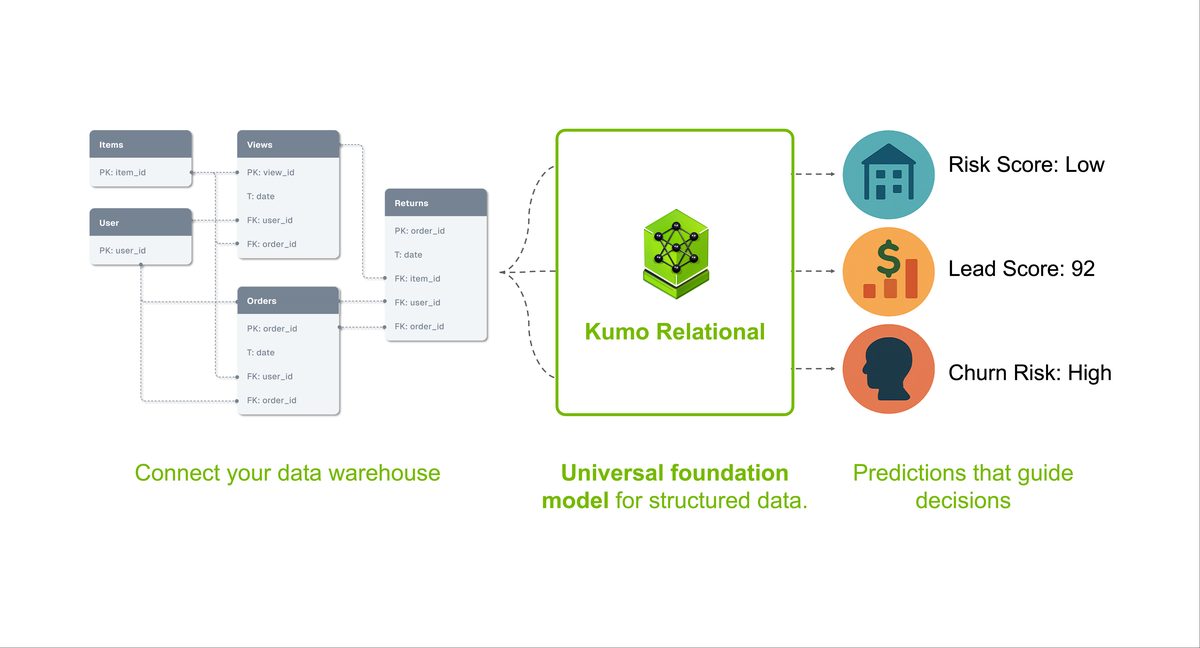
- NVIDIAがリレーショナルデータベース向けに事前学習済みの基盤モデル「Kumo Relational」を発表した。
- 事前のデータ加工や追加学習を行わずに、顧客離脱や需要予測などを単一の推論処理で直接予測できる。
- 15のデータベースによる41タスクの検証で、専門家が調整した従来の機械学習パイプラインを上回る性能を示した。
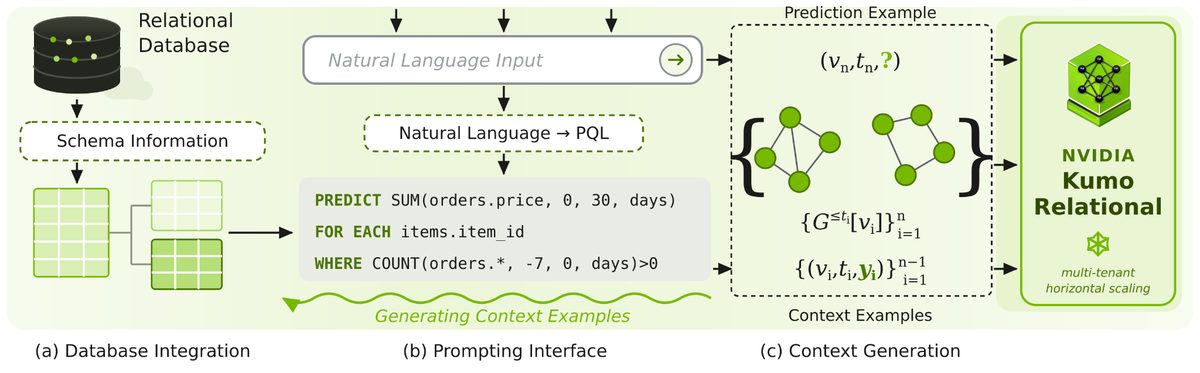
米NVIDIAは、企業のリレーショナルデータベースに対して事前の学習済みのAIに自社データなどを追加で学ばせて、特定の用途に合わせて調整すること。">追加学習なしで直接予測を実行できる事前学習済み基盤モデル「NVIDIA Kumo Relational」を発表した。予測の指示を与えることで、最大10,000件の履歴データを参照しながら、顧客の離脱や需要、不正検知などの結果を1回の推論処理で導き出す。
リレーショナルデータベースを用いた従来の予測モデル構築では、複数のテーブルを手作業で1つの表に集約する平坦化や、数週間に及ぶ特徴量設計、タスクごとのモデル学習が必要とされていた。複数の表を1行にまとめると詳細な構造情報が失われる課題もあったが、Kumo Relationalはテーブル間の関連性や外部キー、タイムスタンプを維持したまま直接処理を行う。
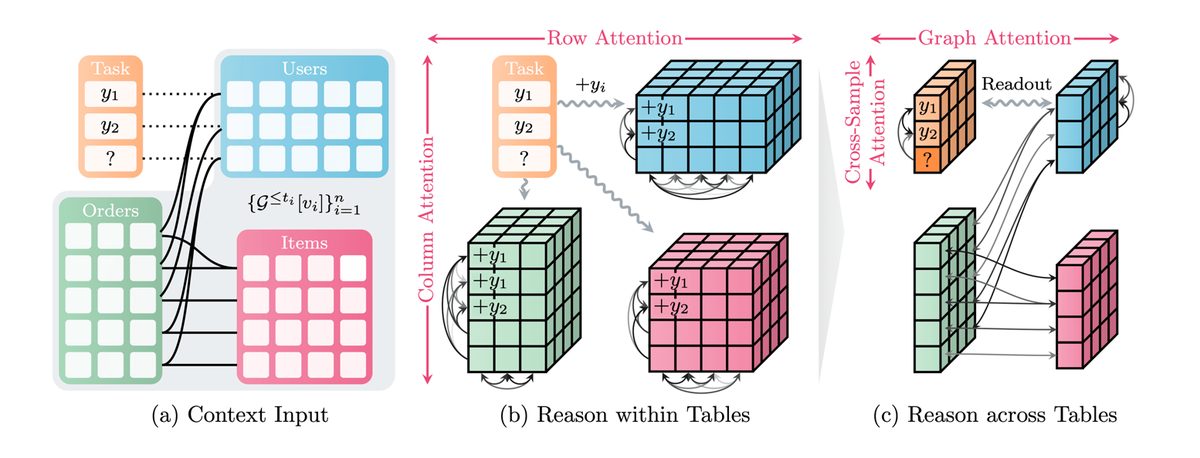
本モデルは、現実のデータベース構造を模した完全な合成データを用いて事前学習されている。推論時には、タスクの内容を「Predictive Query Language(PQL)」と呼ばれる宣言型言語で指示する。モデル内部では、各テーブル内で重要な列や行を特定する処理と、テーブル間の参照関係をたどって情報を結びつけるグラフ処理を組み合わせることで、データの関係性を考慮した推論を実現する。また、過去のデータ状態を再現して推論用データと正解ラベルを分離することで、カンニングにあたるデータリークを防ぐ仕組みを備えている。
性能面では、eコマースや医療、企業データなど15のデータベースにおける41のタスクで検証が行われた。その結果、従来の教師ありディープラーニングモデルや、専門家が特徴量を設計した勾配ブースティング木(XGBoostなど)の性能を上回った。企業の検証環境「SAP SALT」では、複数のモデルを組み合わせるAutoGluonを平均逆順位(MRR)で8%上回り、ファインチューニングを施した場合はその差が16%に拡大した。さらに、ベンチマーク比較「RelArena-α」において、同等の精度を持つ既存手法と比べて約430倍高速に推論を完了したほか、5,000億行を超える規模のデータベースにも対応する。
Kumo Relationalは、ソースコードを無償で一般に公開し、誰でも自由に利用や改良、再配布ができるようにした仕組み。">オープンソースのライブラリ「structured-data-models」または推論実行基盤「NVIDIA NIM」を通じて提供される。ソースコードはApache 2.0ライセンス、モデルの重みはOpenMDW License Agreementバージョン1.1のもとで公開されている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
