スマホの画面内で人の声と唇の動きを再現 高額な計算機を使わず会話できるAIモデルが公開
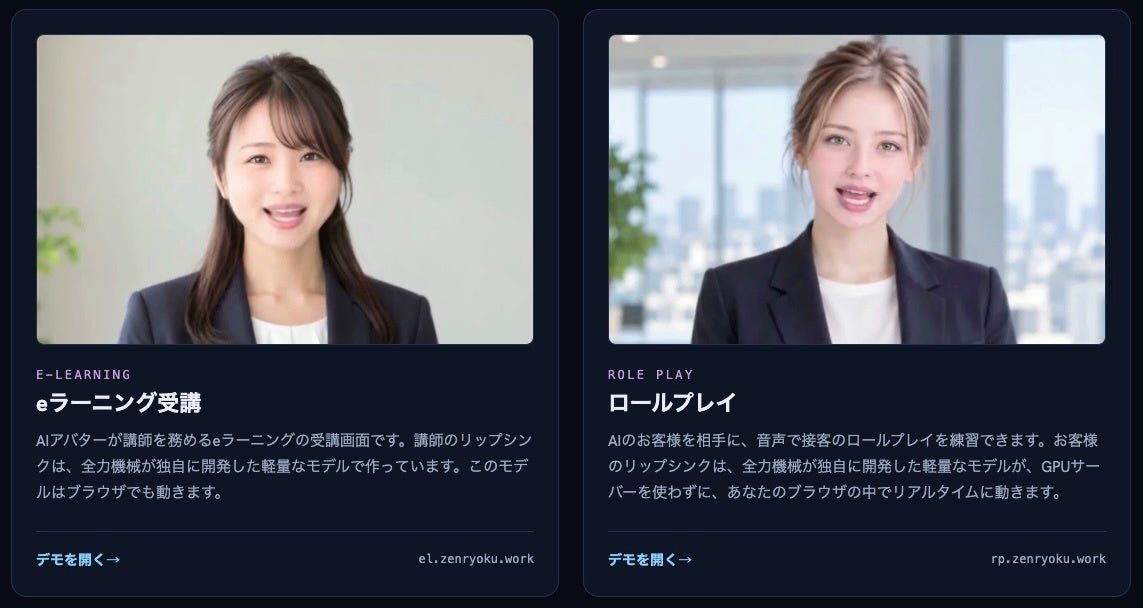
- 全力機械は、スマートフォンの画面上で声の作成と実写映像の口の動きを同時に動かせる対話モデルを公開した。
- 高価な画像処理サーバーを使わず端末内で処理するため、発話終了から約0.3秒の素早い受け答えができる。
- 開発した音声合成や口の動きを制御するモデル、アバターデータや開発キットは無償で公開されている。
全力機械株式会社は2026年10月27日までに、スマートフォンのウェブブラウザ上で実写の唇の動きと日本語の音声合成を同時に実行できるAIモデル群を開発し、公開した。専用の画像処理半導体(GPU)を載せたサーバーを介さず、利用者の端末内で推論処理を完結させる設計により、発話が終わってから約0.3秒で応答できるリアルタイムな対話を実現したという。
従来のAIアバターを用いた対話システムは、クラウド上のGPUサーバーで音声と映像を生成する構成が一般的だった。この方式では通信の往復による表示の遅延が生じるほか、同時接続数に応じて高額なサーバーを増設し続ける必要があった。同社によると、1台で同時に2セッションを処理する前提で試算した場合、同時接続100セッションを支えるにはT4クラスのGPUが50台必要となり、米アマゾン・ウェブ・サービス(AWS)のオンデマンド料金で月額1万9,199ドル(1ドル158円換算で約303万円)の運用費用が常時発生するという課題があった。
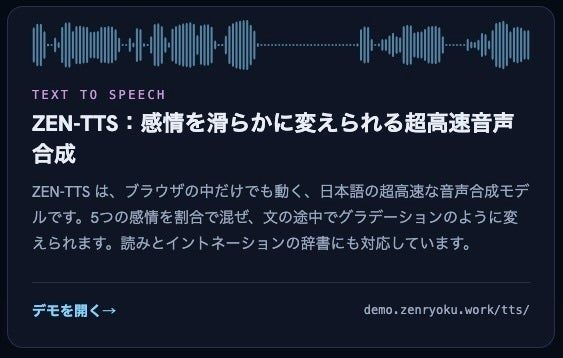
同社は対象となる動画に特化することで、極めて軽量なリップシンクモデル「ZEN-LipSync」と音声合成モデル「ZEN-TTS」を構築した。利用者の端末が持つブラウザ機能(WebGPU)を活用して計算を行うため、端末側で処理する場合は映像や音声の生成にかかるサーバー費用をゼロに抑えられる。端末の性能に依存させない運用形態としてCPUサーバー上で動かすことも可能で、4コアのCPUコンテナ1台あたり同時50セッション規模の処理に対応する。iPhone Airを用いた検証では、5秒の音声を約138ミリ秒で生成し、実時間の約36倍の処理速度を記録した。
ベンチマーク測定において、CPU(Intel Xeon Silver 4316)の1スレッドで動かした場合、ZEN-LipSyncの1フレームあたりの推論時間は2.85ミリ秒となり、先行するオープン技術「DH_live_mini」の6.13ミリ秒を上回る性能を示したという。また、ZEN-TTSも同環境で話す長さの約24倍の速度に相当するRTF 0.042を達成した。同社は、スマートフォンのブラウザ内で音声合成と実写人物の口の動きの同期を同時にリアルタイム実行する公開実装は世界初であるとしている。
公開されたモデル群に加え、マリン、キッカ、ハシロウなどのアバターデータやソフトウェア開発キット(SDK)がGitHub上で配布されている。接客の練習を想定した対話デモや、感情の調整が可能な音声合成デモも公開されており、利用者はブラウザ上ですぐに動作を検証できる。
この記事は PR TIMESの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
