正解データの96.8%が既存AIの出力!? 不動産大手が費用86%削減できたワケ
- 不動産アプリ大手Property Finderで、正解データの96.8%が既存AIの出力だった評価の偏りが判明した。
- 専門家による再採点や複数ラベル対応、プロンプト最適化を重ね、公平な比較環境を整えた。
- 新モデルの採用により、従来モデルと比べて大幅な精度向上を達成し、費用を86%削減した。
AIモデルを刷新したら精度が跳ね上がり、運用コストが86%も浮いた――そんな都合の良すぎる話があるだろうか。安くて賢いモデルへ乗り換えたいのは山々だが、ここまで劇的な成果を出せるものなのか。実はその裏には、AI導入企業なら誰もが陥りかねない“危険な罠”が潜んでいたのだ。
AWSの公式ブログが明かしたところによると、舞台となったのは中東・北アフリカで不動産アプリを展開するProperty Finder。同社は日々数万枚に及ぶ物件画像を処理し、1枚あたり11もの品質項目をAIで判定している。ところが、より低コストなモデルを探す過程で驚くべき事実が発覚した。新モデルの性能を測るはずの評価データの実に96.8%が、既存モデルAの出力をそのまま流用したものだったのだ。これでは新モデルがいくら正しく判定しても「不正解」とみなされてしまう。
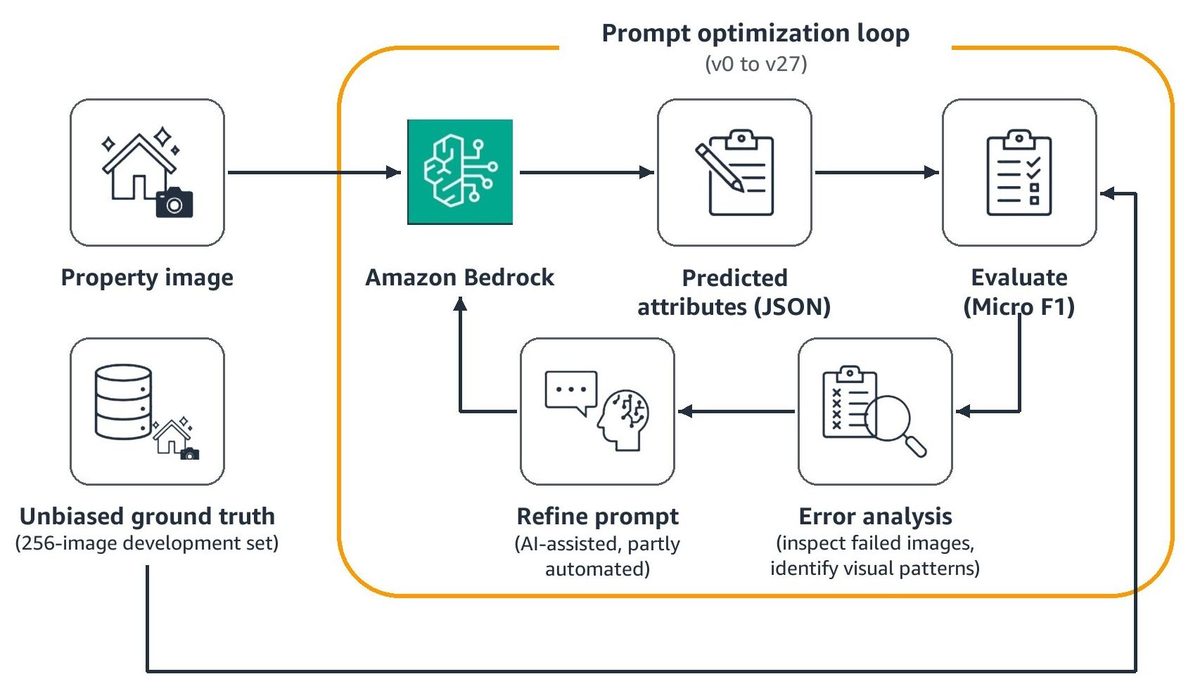
同社はAWSの支援を受け、専門家による手作業の再採点を敢行。単一ラベルから複数ラベルへの変更や、プロンプトの27回に及ぶ反復調整などを重ねた。その結果、Bedrock上の「Llama 4 Maverick 17B Instruct」を採用した新構成で、F1スコアを従来の0.56から0.80へと大幅に改善させ、86%の費用削減を勝ち取ったという。
ここからは編集部の推測だが、正解データのほとんどが既存AI頼みになっていた背景には、膨大な画像処理を急ぐあまり、データ整備の工数を惜しんでしまった過去の事情があるとみられる。自前の判定を信じ切った結果、知らず知らずのうちに“自作自演の評価ループ”に閉じ込められていたのではないだろうか。
確かなのは、評価の偏りを正したことで大幅なコスト削減と精度向上が証明された点だ。自社のAI評価データも過去のモデルに毒されていないか、点検してみる価値は大いにある。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
