スマホでも動く小型AI「LFM3」公開、画像や音声も手元のパソコン1台で追加学習
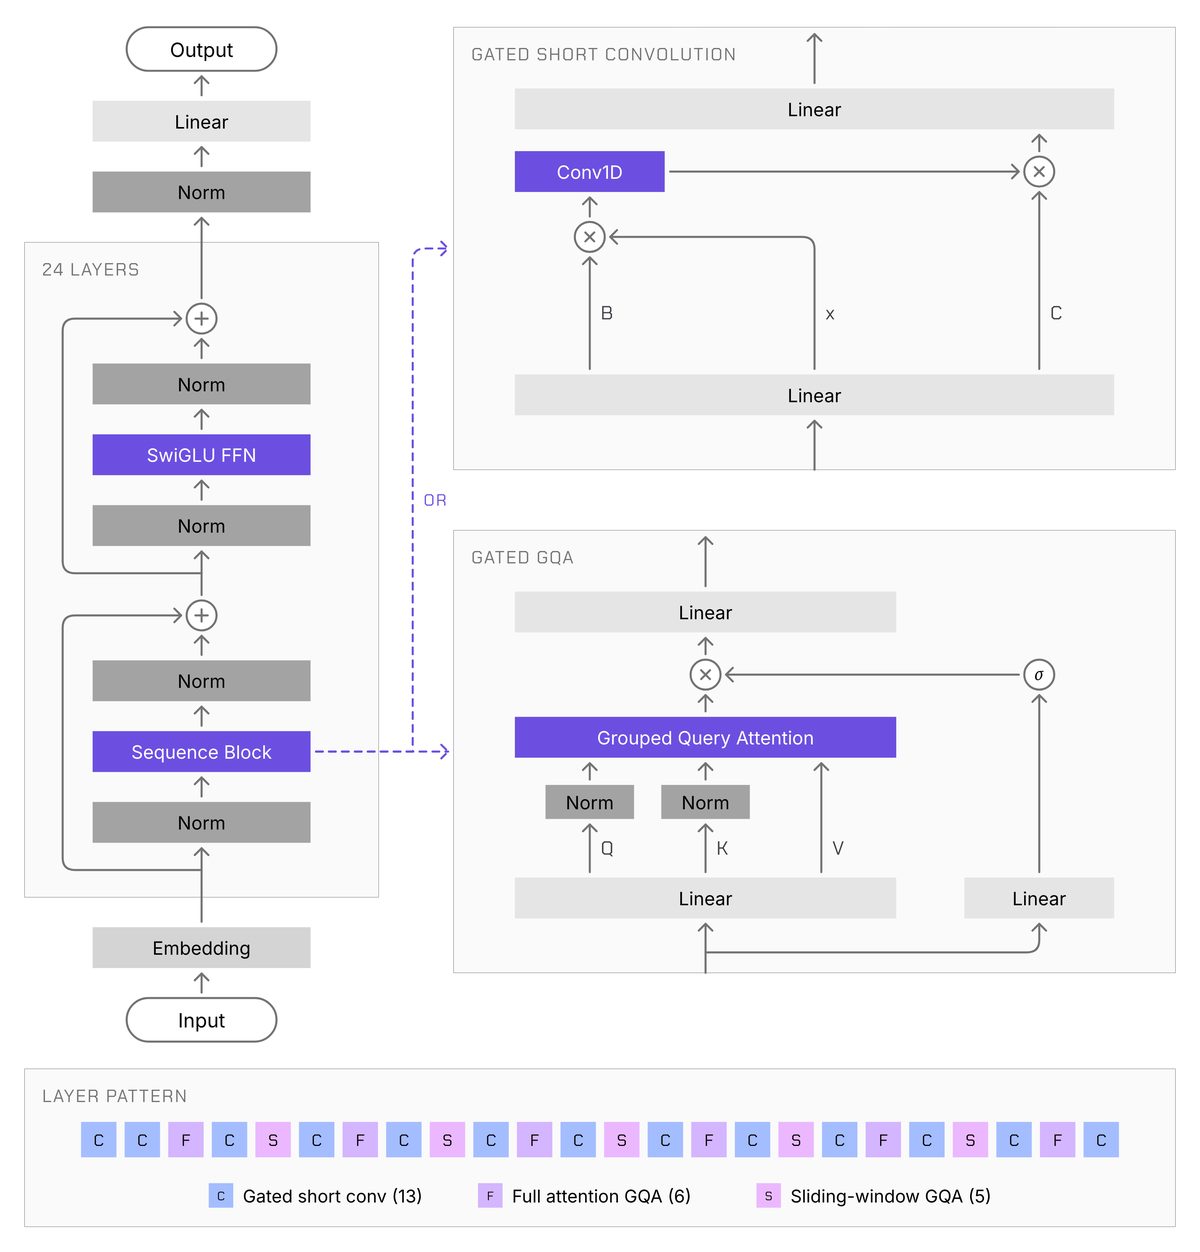
- テキストや画像、音声などを用途別に分けた小型AI群「LFM3」が公開され、共通の基盤から構築された。
- 前世代と比べ35%少ない計算規模で高い性能を発揮し、最長25万6000語規模の長い文脈処理に対応する。
- 全モデルがGPU1枚で追加学習できるほか、4ビット化で約1GBに収まり端末上での高速動作を実現する。
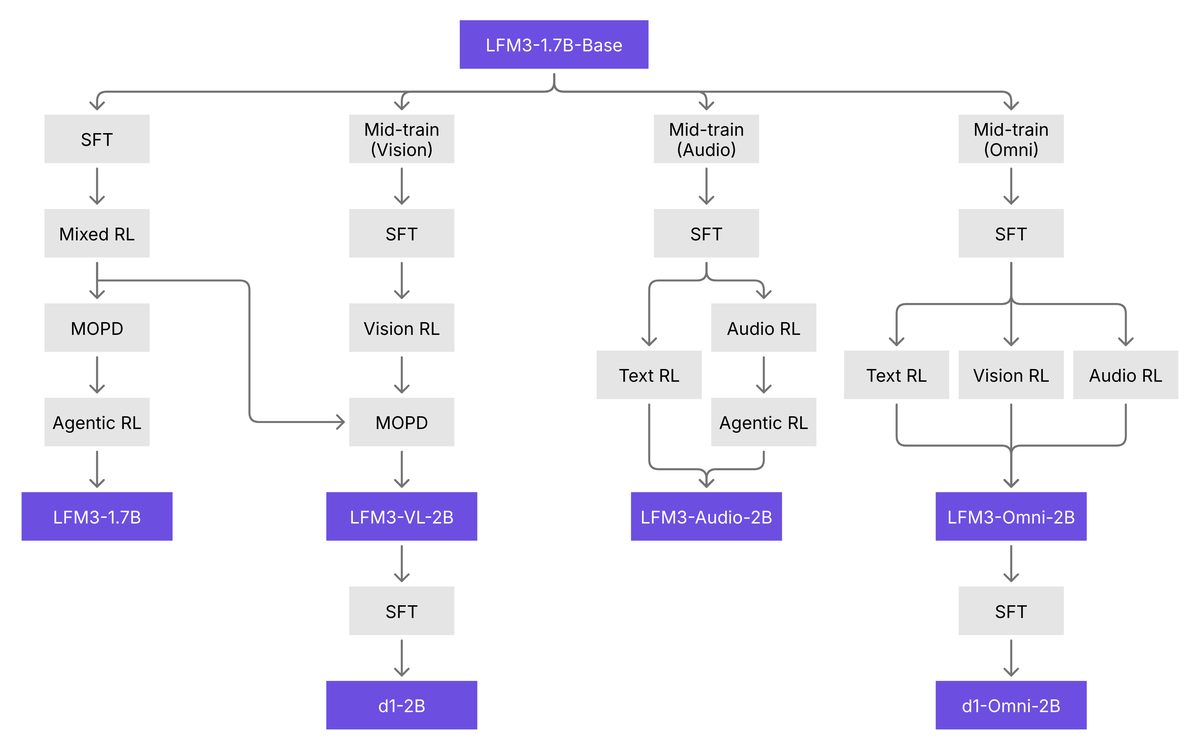
Liquid Foundation Modelsの新世代となるAIモデル群「LFM3」が公開された。LFM3は、テキスト、画像(視覚)、音声、オムニ、意思決定の各モデルを約20億(2B)学習で調整される膨大な数値。「7B」は70億個の意味で、多いほど賢くなる傾向があるが動かすコストも増える。">パラメータ規模の共通バックボーンから分岐させて構築した基盤モデル群である。利用者は対象とするデータ種別に応じてモデルを選び、GPU(画像処理半導体)1台を使って手元のデータで追加学習(ファインチューニング)を行い、各種端末へ直接組み込んで運用できる。
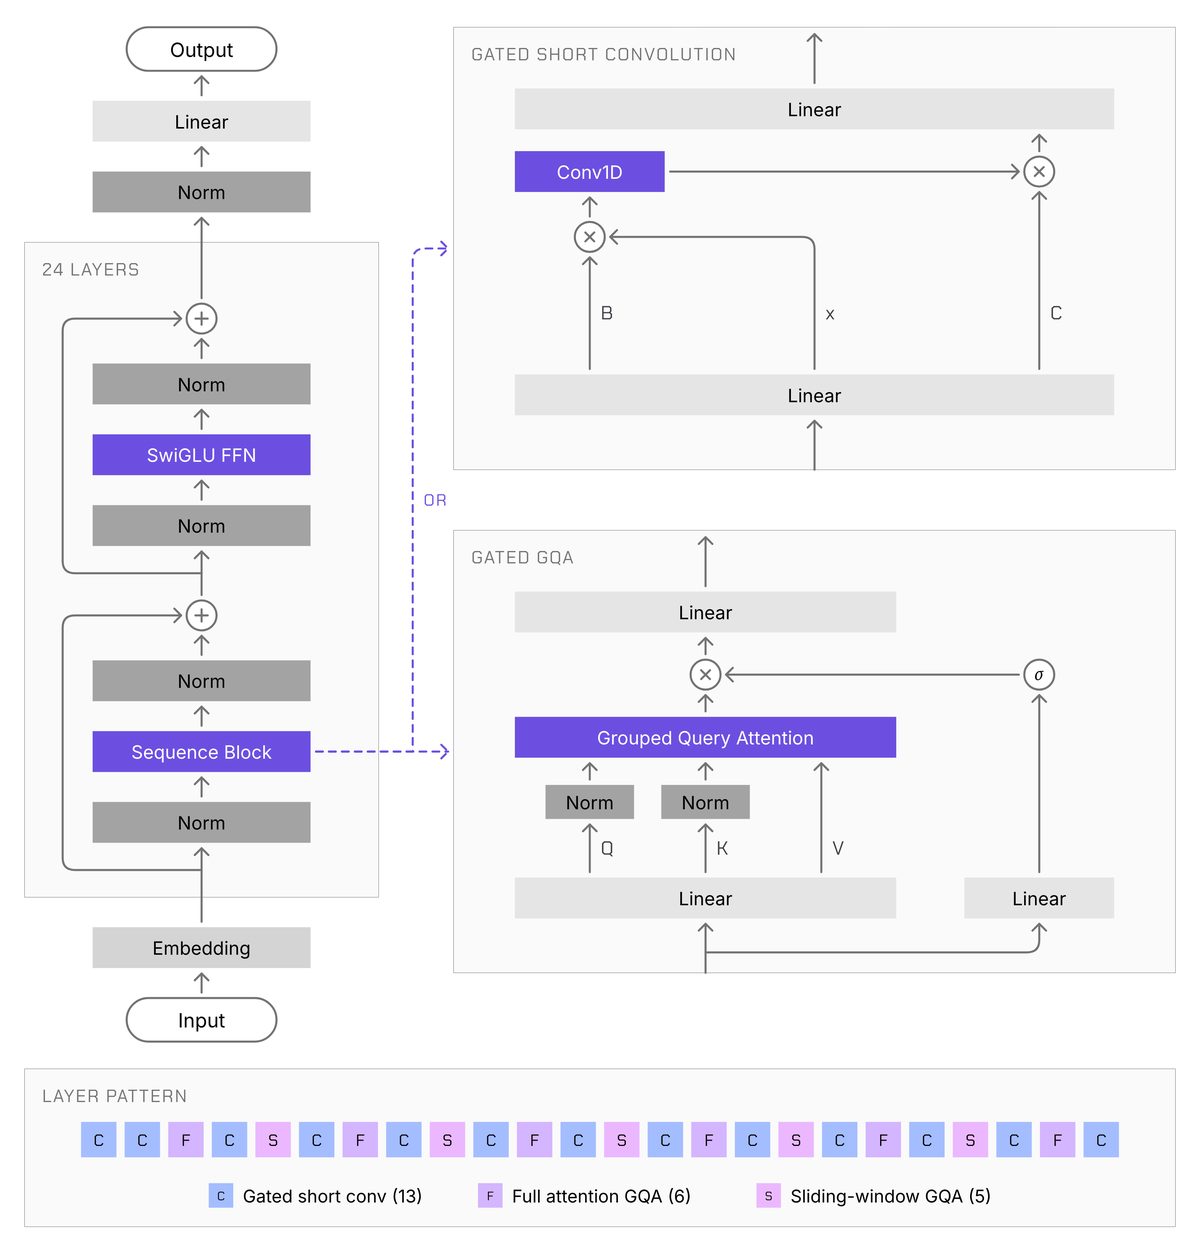
開発の背景には、高度な汎用モデルが存在する一方で、個別用途や端末上での実行(エッジ利用)に特化した高速・軽量なモデルが求められている状況がある。LFM3では、短い畳み込み(コンボリューション)、局所的なスライディングウィンドウアテンション、大域的アテンションを組み合わせた「トライハイブリッド構造」を新たに採用した。これにより、前世代の「LFM2.5-2.6B」と比較してパラメータ数を35%削減しながら性能向上を達成した。事前学習には22兆(22T)トークンを使用し、文脈窓(コンテキスト長)は最長25万6000(256K)トークンに達する。4ビット量子化を行えばテキストモデルは約1GBの容量に収まり、長文脈の処理でも高速に推論を実行できる。
ラインアップには複数の専門モデルが含まれる。中核となる言語モデル「LFM3-1.7B」は自律型AIエージェントの処理に適しており、WebArena-Verifiedベンチマークで38.42のスコアを記録した。視覚モデル「LFM3-VL-2B」は動画入力に初対応し、62種類の視覚ベンチマークの平均スコアを前世代の57.6から71.4へ引き上げた。音声モデル「LFM3-Audio-2B」は18言語に対応し、新開発の音声トークナイザー「LiquidCodec」により高速なストリーミング音声出力を可能にしている。さらに、これらを統合し画像・動画・音声の同時理解と音声対話ができる「LFM3-Omni-2B」や、分類・抽出に特化した構造化決定モデル「d1-2B」「d1-omni-2B」も用意された。
ロボティクス分野への応用では、LFM3-VL-2Bをベースに開発された行動生成モデルが、ロボット評価ベンチマーク「LIBERO」の4スイートにおいて平均96.2%の成功率を記録した。組み込み向けハードウェアであるJetson AGX Orin環境において50ミリ秒未満での動作生成を実現している。LFM3の各モデルは重みデータがオープンな形式で公開されており、Hugging Face上でダウンロードおよび利用が可能となっている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
