エヌビディアが誰が何を話したか指示文で書き分けるAIを公開、100時間分を3分で処理
- 指示文に合わせて文字起こしや翻訳、話者ごとの発言区切りなどを1つで切り替えられる音声AIを公開した。
- 40言語の文字起こしや最大8人の話者識別に柔軟に対応し、複数の公開性能評価でオープンモデル首位を獲得した。
- 訓練データ整備基盤も同時公開され、専門用語を指示文や追加学習で正しく書き分けられる仕組みを整えた。
米NVIDIAは、自然言語の指示文に応じて文字起こしや話者の識別、翻訳などを柔軟に出し分けるオープン学習を通じてこの数値を細かく調整することで、正しい答えや予測を出せるようになります。">重みの音声モデル「Nemotron 3.5 Transcribe」を公開した。モデル共有基盤のHugging FaceやModelScopeを通じて提供している。
録音データの文字起こしでは、誰が発言したかの区別や外国語の翻訳、専門用語の正確な表記など、利用場面ごとに求められる出力形式が異なる課題があった。同モデルは単一のモデルで40言語の文字起こし、31言語と英語との間の翻訳、13言語の話者識別のほか、音声内容に関する質問応答に対応する。最大1時間の録音データを扱い、最大8人までの話者を識別して発言内容を割り当てることができる。
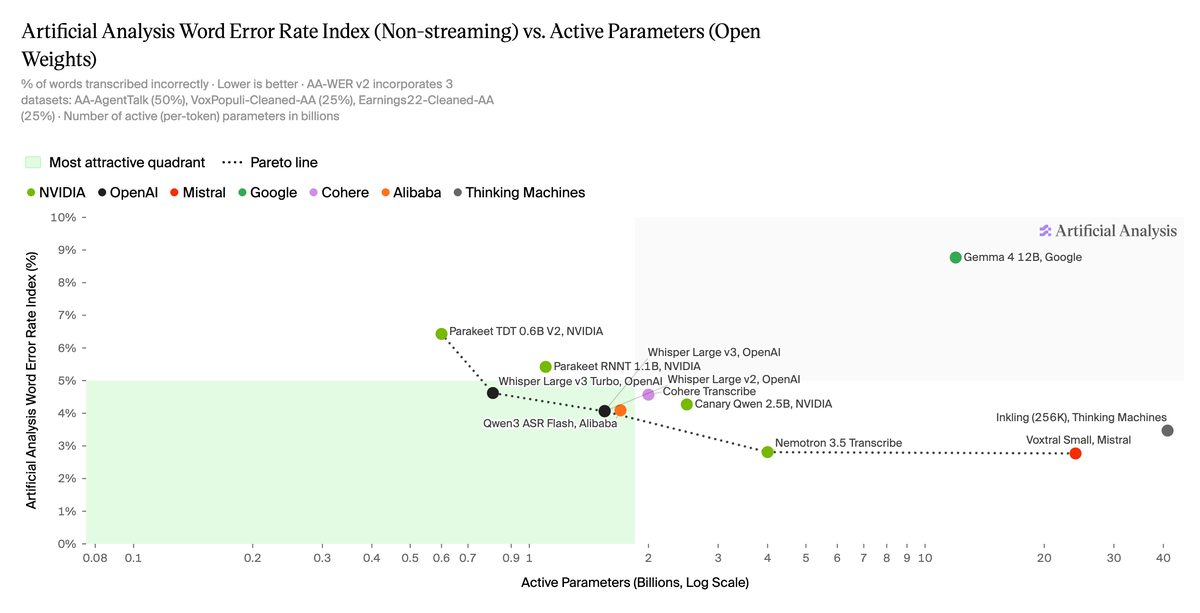
モデル構造には、音声特徴を読み取るエンコーダと、MambaおよびTransformerを組み合わせた混合エキスパート(MoE)方式の言語モデルを採用した。総パラメータ数約300億のうち、1つの単語処理で実際に稼働するパラメータを約40億に抑えている。単一のNVIDIA製GPUで動作し、RTX PRO 6000 Blackwell Server Editionを1基使用した検証では、100時間分の音声を3分未満で処理したという。
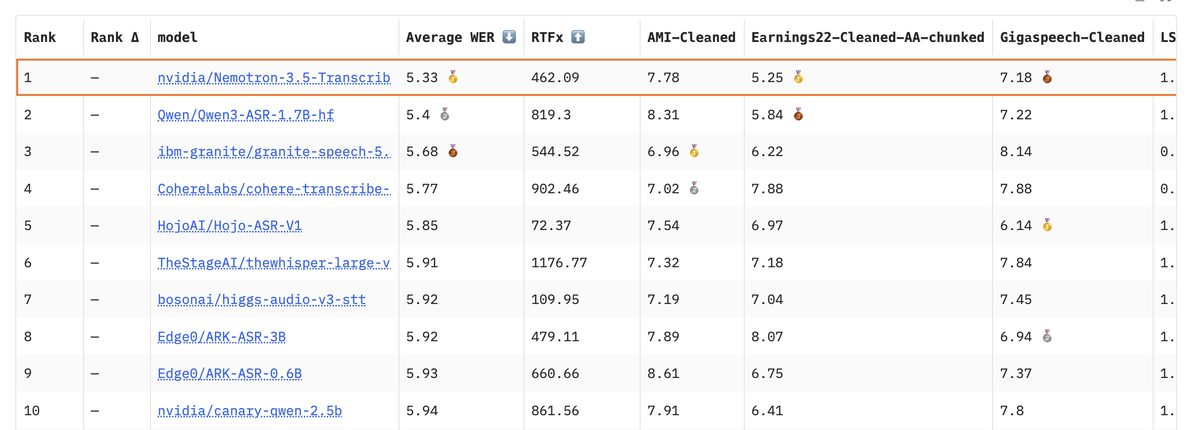
性能面では、Hugging Faceの英語音声認識リーダーボードにおいて、オープン重みモデルとしてトップとなる平均単語誤り率5.33%を記録した。話者識別の評価でも、21言語を対象とするDavid AIのベンチマークやVoiceArenaの比較評価で誤り率の低さ首位を獲得している。
同社はあわせて、このモデルの学習を支えた多言語データ整備基盤「Granary v2」も公開した。前身の25言語から48言語・46万3,062時間分に規模を拡大し、音声の前処理や文字起こし、品質検査など4段階の自動処理パイプラインを提供する。医療現場を想定した事例検証では、指示文の工夫に加えて専用データによる追加学習を行うことで、単語誤り率を45.8%低減できたとしている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
