AIが別のAIの内部データを直接書き換え、算数の正解率を6倍に引き上げる手法が登場
- 最先端AIが別のモデルの内部数値を直接読み書きし、再学習なしで性能を改善する実験結果が公開された。
- 小型モデルの数値をわずか0.016%修正しただけで、数学テストの正解率が7.9%から48.1%へ急上昇した。
- 従来は人にも困難だった内部構造の解析や欠陥修正を、AI自身が論理的に推論して行う新たな試みとなる。
最先端の学習して、人間のように文章を理解・生成できるAI。ChatGPTやGeminiの中身。">大規模言語モデルが、ニューラルネットワークの「重み」と呼ばれる内部数値を直接読み取り、さらに直接書き換えて性能を向上させられることが実験で明らかになった。研究チームはこの手法を「Weight-Space Programming(重み空間プログラミング)」と名付け、結果を公開した。
ディープラーニングの歴史において、モデルの重みは勾配降下法などの最適化アルゴリズムを通じて機械的に更新されてきた。その数値の並びは複雑で、人間が直接読み解いて目的の動作をさせたり、手作業で数値を修正したりすることは事実上不可能とされてきた。今回の研究は、汎用言語モデルである「GPT-6 Astra」が重みの数値を直接把握し、最適化ループや追加の環境フィードバックを介さずに、論理的な推論に基づいて修正できることを示している。
わずか0.016%の修正で数学性能が急上昇
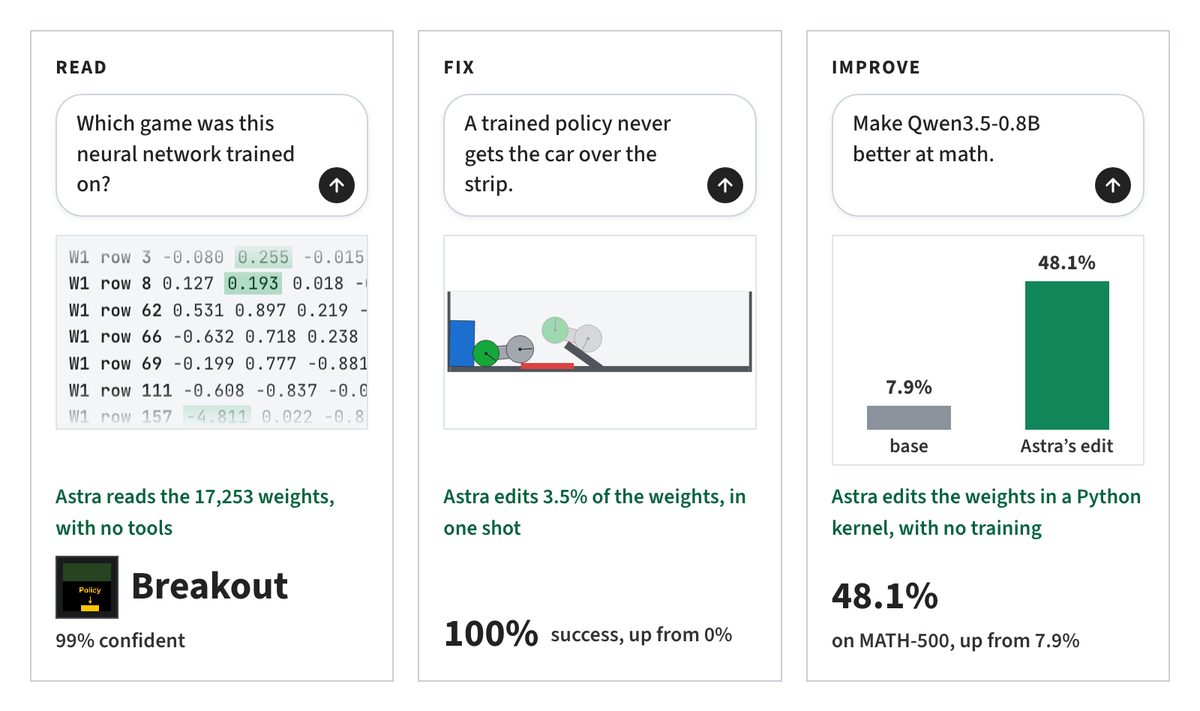
実用的なモデルに対する実験では、小型言語モデル「Qwen3.5-0.8B」の数学能力の改善が試みられた。Astraは勾配計算を行わず、同モデルの重みの中に存在して推論のループを引き起こしていた問題を特定した。そして全体のわずか0.016%にあたる重みを直接編集した。
この修正により、数学ベンチマーク「MATH-500」の正解率は7.9%から48.1%へと大幅に向上した。さらに、指示追従性能を測る「IFEval」のスコアも事前設定なしで3倍に改善したという。
重みを見るだけで学習内容を特定
言語モデルが重みの意味を理解できるかを検証した基礎実験でも、特筆すべき結果が得られている。強化学習(PPO)で10億ステップ学習させた4種類のゲーム(Breakout、Pong、Pac-Man、Freeway)の操作モデルについて、重みのデータだけをテキストとしてAstraに渡したところ、選択肢を与えられていない状態から4つすべてのゲーム名を正確に言い当てた。
また、円や三角形を描く拡散モデルの重みから描画対象の図形を特定したほか、入出力層を取り除いた小規模言語モデルの中間層だけを渡された実験でも、学習に使われた言語(Pythonコード、ローマ字表記の日本語、英語)を特定し、過去の文字列を記憶・複製する役割を持つヘッドを正確に見つけ出した。
局所解に陥った物理制御の失敗も一発修正
重みを修正するタスクでは、物理シミュレーション環境「Kinetix」で坂を登れずに立ち往生していた走行車両の操作モデルが対象となった。Astraに重みと失敗した走行ログを提示したところ、局所的な最適解に陥っている原因を特定。全体の3.5%の重みを書き換える修正を1回加えただけで、256回の試行で一度も成功していなかったタスクが、1,024回すべての試行で成功するようになった。
研究チームは、これまでプロンプトや学習コードの調整に使われていたLLMの推論能力が、今後はネットワークの重みそのものを直接最適化する領域へと拡大していく可能性を示唆している。
この記事は rikiyat.github.ioの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く