AIは長い文章の変化を正しく追えるか 最先端モデルでも難問で正答率13%以下に
- 文章中の状態変化を追跡する能力を4段階の難易度で評価する新ベンチマーク「StateBench」が発表された。
- 最先端モデルでも複雑な依存関係を含む長文では精度が急落し、最難関問題では正答率が13%以下に落ち込んだ。
- 直接学習させた検証では、再帰型やハイブリッド型の構造が従来のTransformerよりも高い汎化性能を示した。
長い文章の中で対象の状態がどのように変化したかを学習し、次に来る確率の高い単語を予測して文章の理解や作成を行うAIの仕組みのこと。">言語モデルがどれほど追跡できるかを測る新たな評価ベンチマーク「StateBench」が公開された。物語の中で凶器となるナイフが誰の手に渡ったかを追う場面や、プログラムコード内で変数の値が再代入される処理など、状態の追跡は多くの言語理解タスクの根底にある。検証の結果、最先端のモデルであっても、複雑な依存関係を伴う長い入力では正答率が13%以下にまで落ち込むことが明らかになった。
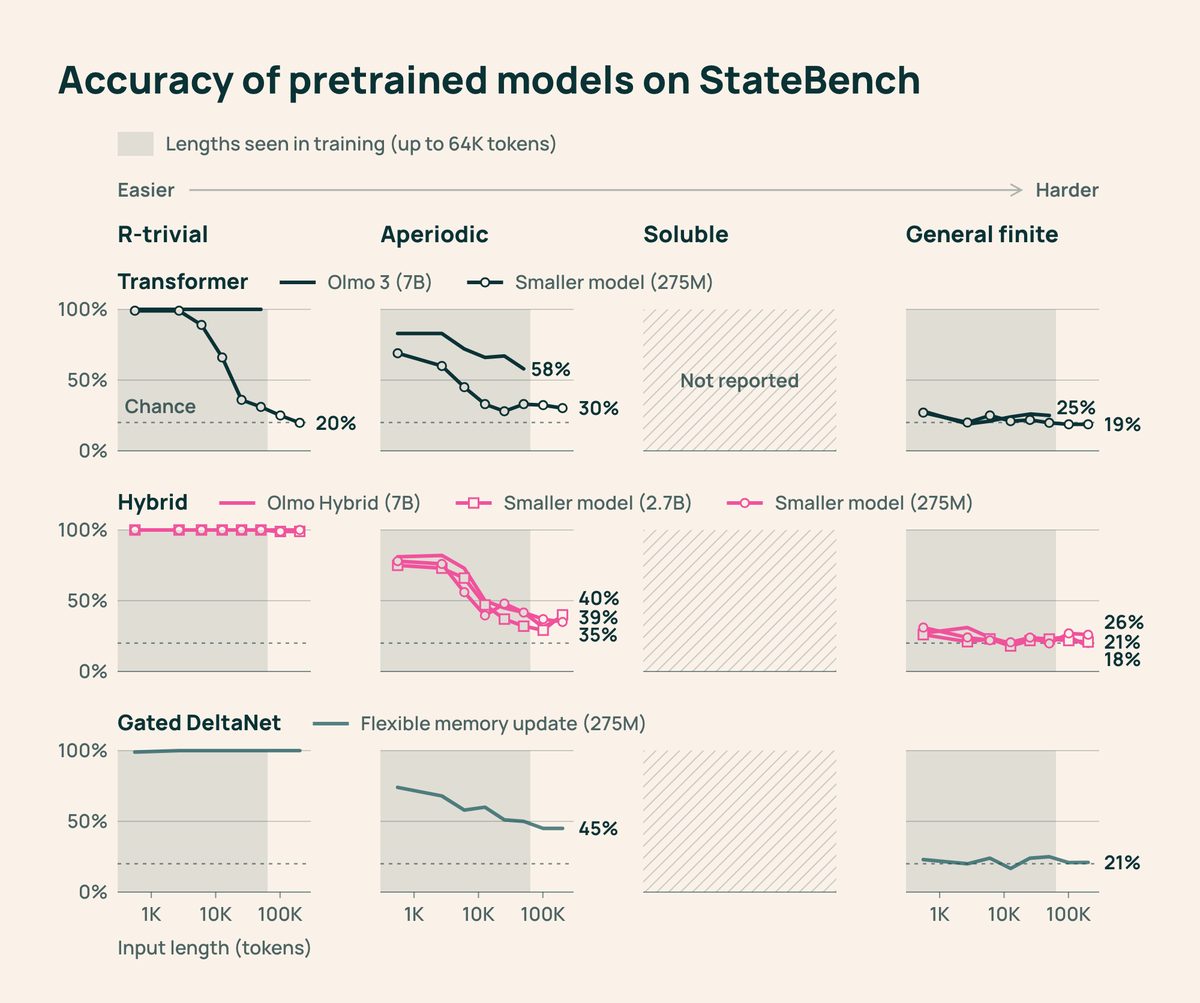
StateBenchは、代入操作の複雑さに応じて4つの難易度レベルを設定している。値が一度決まると変わらない「R-trivial」、最新の値への上書きのみを追えばよい「Aperiodic」、過去の値を元に加算などを繰り返す「Soluble」、そして変数同士の参照や入れ替えが発生する「General finite」で構成される。これらは代入操作の形式だけでなく、代数系のクローン・ローズ理論(Krohn–Rhodes theory)に基づき、状態追跡問題を基本要素へと分解して体系化した設計となっている。
公開されている事前学習済みモデルおよび先端モデルを用いた評価では、難易度による性能差が鮮明に現れた。Gemini 3.8 Flash、Claude Opus 5.5、GPT-6 SolおよびLunaの4つの先端モデルは、平易なレベルでは高い精度を示したものの、連鎖的な変化を追うSolubleやGeneral finiteでは入力が長くなるにつれて精度が急落し、最長のGeneral finite問題では正答率が13%以下に低下した。難度が高い問題では途中の1つの変化を見落とすだけで最終的な答えを誤るため、敏感性が大きく影響したとみられる。
モデル構造ごとの限界を確かめるため、StateBenchの課題を直接学習させる実験も実施された。最大256ステップの代入操作で学習させた2億7500万パラメータのモデル群を、学習長の250倍にあたる最大6万4000ステップの入力でテストしたところ、構造間で明確な乖離が生じた。従来のTransformer構造は最難関の課題を学習できなかった一方、記憶を保持して伝達するGated DeltaNetやハイブリッド構造のモデルは、数万ステップの長さに対しても高い汎化性能を示した。
現行のStateBenchは変数の数が固定されている設定を前提としており、現実の長文対話のように新しい登場人物や物体が次々と加わる状況にはまだ対応していない。研究チームは、新たな再帰型やハイブリッド構造のモデルが登場するなかで、どの構造がどのような状態追跡に適しているかを把握することが今後のシステム開発や学習の指針になるとしている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
