エヌビディアが記憶容量不足を解消、計算効率を最大30倍高める新設計を公表
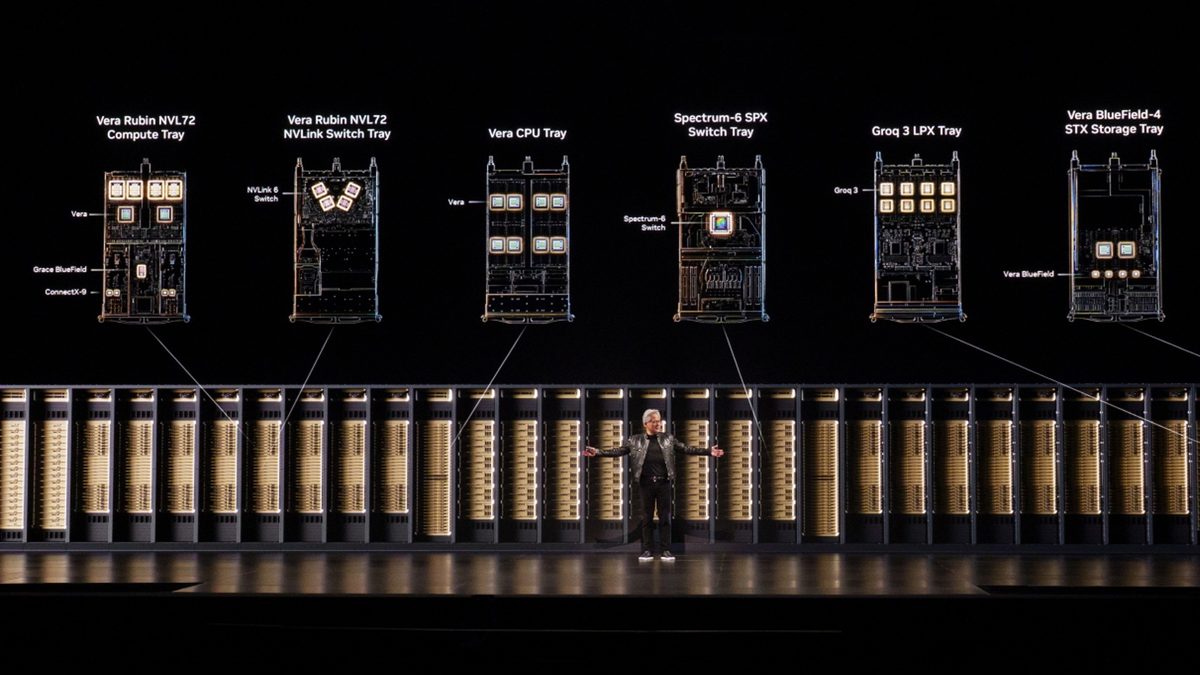
- 巨大化するAIで半導体の記憶装置が不足する課題に対し、全体を協調設計して効率を高める手法を公表した。
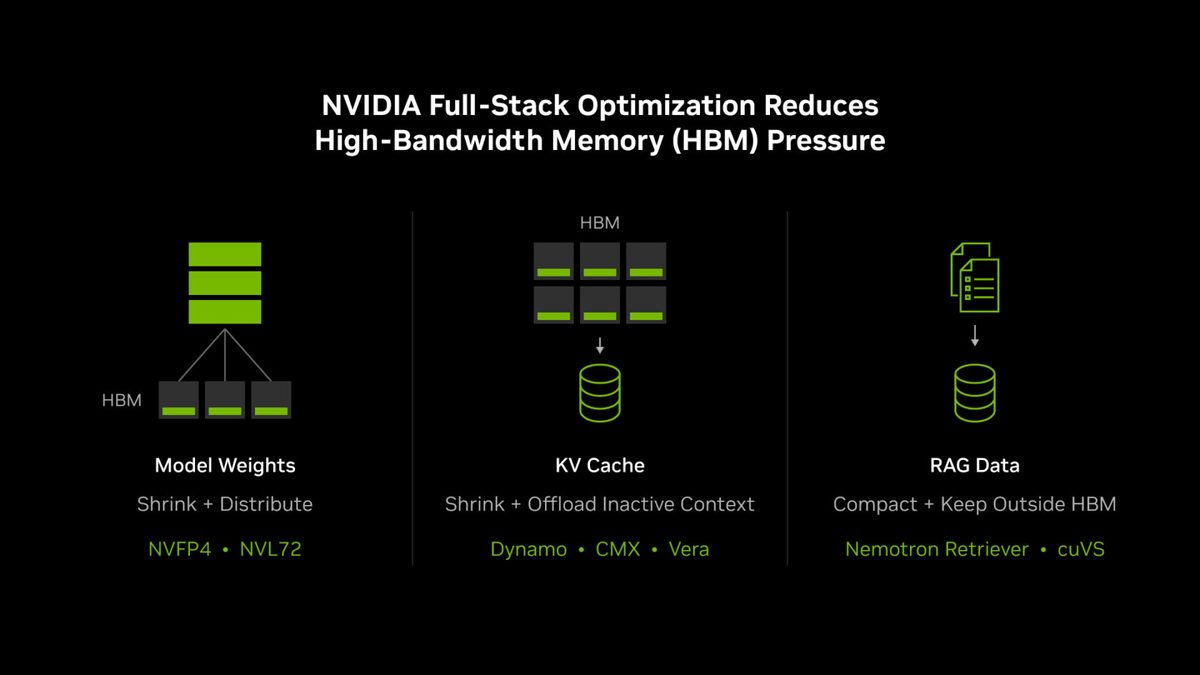
- データを4ビットへ圧縮して分散し、使わない文脈は低価格な外部ストレージへ退避して容量を節約する。
- ベンチマーク評価では、最新基盤において費用あたりの処理能力が従来比で最大30倍に向上したとしている。
米NVIDIAは2026年11月5日、AIの大規模化やエージェント型処理の普及に伴って深刻化するGPUのメモリ不足に対し、ハードウェアとソフトウェアを一体で設計する「フルスタック・コデザイン」によってメモリ利用効率を大幅に高めるアプローチを公表した。単にGPU上の広帯域メモリ(HBM)を増やすのではなく、システム全体の階層構造を最適化することで、費用あたりの処理性能を劇的に向上させたとしている。
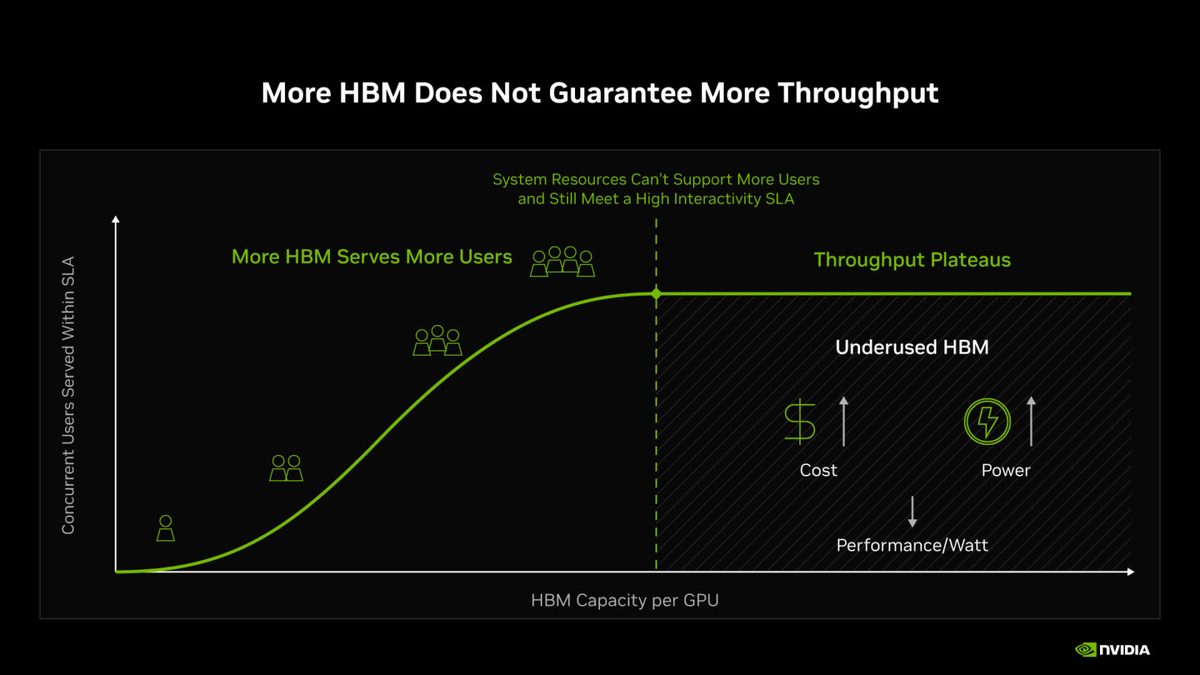
AIモデルのパラメータ数が兆単位へと巨大化し、複数回のツール呼び出しを伴うエージェント処理では最大300万トークンの文脈を保持する必要が生じるなど、推論時にモデルの重みとKVキャッシュがHBMを圧迫している。しかし、荷降ろし場に相当するメモリ帯域がボトルネックとなる「メモリの壁」が存在するため、HBM容量を増やすだけでは処理遅延やコスト、消費電力が増大し、効果的に活用できない課題があった。
同社はこの課題に対し、データを圧縮して適切な階層へ配置する手法を提示した。HopperプラットフォームのFP8形式に比べ容量を抑えられる「NVFP4」形式を採用し、モデルの重みとKVキャッシュを4ビット精度へ圧縮する。さらに、最大72基のGPUを接続する「NVL72」環境で重みを分散配置するほか、待機中の文脈データはNVLink-C2Cで接続された「Vera CPU」のLPDDRメモリや、共有コンテキストストレージ「NVIDIA CMX」へと一時的に退避させ、再利用時に戻す制御を「NVIDIA Dynamo」ソフトウェアで実行する。
RAG(検索拡張生成)においても、「NVIDIA Nemotron Retriever」で埋め込み表現を小型化し、検索インデックスを「NVIDIA cuVS」によりCPUやストレージ側に保持することで、HBMの消費を抑制している。NVFP4のチェックポイントは、Black Forest Labsの「FLUX.2 [klein]」やMetaの「Meta Muse Spark」など複数の最新モデルで採用が進んでいる。
SemiAnalysis AgentXの「DeepSeek V4 Pro」ワークロードを用いた検証によると、GPUあたりのHBM容量が約2倍となった「GB300 NVL72」は、1人あたり毎秒100トークンの条件下で従来のH200プラットフォームに比べ費用あたり最大10倍のスループットを達成した。さらに「Vera Rubin NVL72」では、HBM容量の増加が約3%にとどまるものの、1人あたり毎秒125トークンの条件下でGB300 NVL72に対し費用あたり最大30倍の性能向上を達成したという。
この記事は NVIDIA 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
