絵の中の配置を自由に指定できる新画像AI、1枚を約2秒で作成可能に
- Black Forest Labsの画像生成AI「FLUX.3 Image Klein」がDiffusersで提供開始された。
- 1つのモデルで文章からの生成や編集、枠線での位置指定を行い、H100で1枚約2秒で描画する。
- 構造面ではQwen3-VLから特徴を抽出するほか、個別処理と統合処理を分けた2段階構成を採用した。
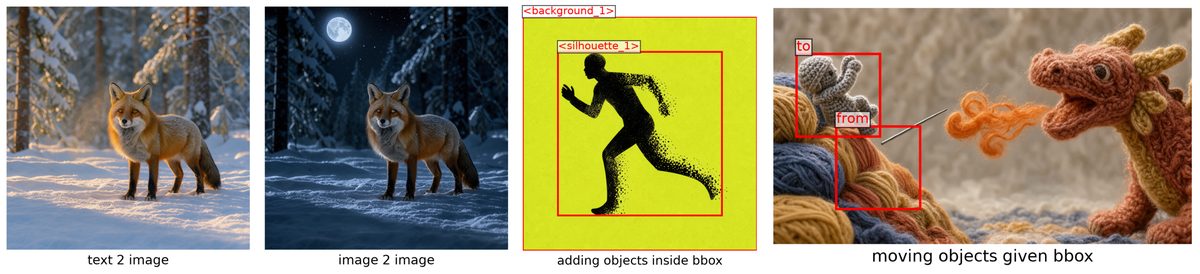
Black Forest Labsが開発した画像生成モデル「FLUX.3 Image Klein」が、機械学習ライブラリ「Diffusers」で公開された。本モデルはテキストからの画像生成だけでなく、複数の参照画像を用いた画像編集、さらには枠線指定による画像のレイアウト制御までを単一のモデルで処理できる点が特徴だ。
位置制御と画像編集の統合
新機能となるレイアウト制御では、プロンプト内に矩形領域(バウンディングボックス)の情報を記述することで、画像内の各要素を配置する位置を指定できる。座標は画像の大きさに関係なく0から1000の範囲で正規化されており、出力解像度を問わず同じ設定を利用できる。画像編集においても、参照画像のどの部分を生成画像のどの位置へ移動させるかを指定可能であり、既存の背景や要素を固定したまま特定の部分だけを移動させるといった編集に対応する。
生成速度とモデル構成
モデルは主に2種類のチェックポイントが提供される。推論を高速化した蒸留版(distilled checkpoint)は、NVIDIAのH100 GPU環境において、1024×1024ピクセルの画像を16ステップ、約2秒で生成する。一方のベース版は50ステップで動作し、追加学習(LoRA)向けに設計されている。また、メモリ容量の小さいGPUでの運用を想定し、bf16形式のほか、行単位のFP8(fp8r)やnvfp4といった量子化形式の重みファイルも用意されている。
多層特徴の抽出と2段階の処理構造
内部構造にも複数の改良が加えられた。テキストエンコーダーには視覚言語モデル「Qwen3-VL」を採用し、全36層のうち8層(第4層、第8層から第32層まで)から隠れ状態を抽出して結合している。これにより得られる20,480次元の特徴を線形層で3,072次元に射影して利用する。続く生成AIの土台になっている仕組み。文中の単語同士の関係を一度に見渡せるのが特徴。">トランスフォーマーは2段階で構成され、第1段階ではテキスト、画像、参照画像の各系列が独立した5ブロックの重みで処理される。第2段階では3つの系列が結合され、共通の重みを持つ28ブロックで相互に情報を参照する。従来のFLUX.2が最初からテキストと画像を相互に参照させていたのに対し、FLUX.3は一度個別に処理してから統合する形式をとる。
4軸の位置情報とパイプライン設計
トークンの位置情報には、時間、高さ、幅、系列長の4つの軸を持つ回転位置埋め込み(RoPE)が使われている。参照画像と生成画像で同じ平面座標を共有することで、位置指定による正確な編集を可能にした。さらに本モデルは「Modular Diffusers」パイプラインとして提供され、テキストエンコーダーを事前に実行してメモリを解放するなど、処理工程を柔軟に差し替えられる設計となっている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
