米新興が超大型AIを無料公開、自前の機器で動かせ本数百冊を一気に処理
- 米Reflectionが5010億パラメータのオープンモデル「Beam」をApache 2.0で公開した。
- 100万トークンの文脈に対応し、推論時は一部のみを動かすことで230億規模の速度で動作する。
- コード生成や自律型エージェントに特化し、自社インフラでの運用や用途に応じた微調整に対応する。
米国の新設AI研究組織であるReflectionは2026年10月16日、5010億(501B)学習で調整される膨大な数値。「7B」は70億個の意味で、多いほど賢くなる傾向があるが動かすコストも増える。">パラメータを持つオープンな大規模言語モデル「Beam」をHugging Face上で公開した。ライセンスにはApache 2.0を採用している。入出力ともにテキストに対応し、100万(1M)トークンの文脈長を備える。コーディングや自律型エージェントの用途に焦点を当てて開発されており、自前のハードウェアやクラウドインフラ上で最先端規模のモデルを運用し、自社用途にカスタマイズしたい開発チームを対象とする。
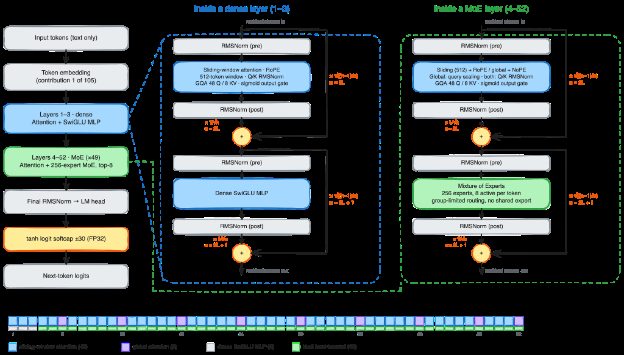
BeamはMixture-of-Experts(MoE)構造を採用しており、全5010億パラメータのうち1トークンの計算あたり230億(23B)パラメータのみを稼働させる。これにより、大規模モデルの容量を維持しながら、小規模モデル並みの速度で処理できる。デコーダーは52層で構成され、MoE層には256個のエキスパートが配置され、トークンごとに8個が選択される。注意機構には直前の512トークンを参照するスライディングウィンドウ層43層と、文脈全体を参照するグローバル層9層を組み合わせたハイブリッド構成を取り入れ、長文脈処理に伴うキャッシュメモリの増大を抑制している。
提供形式はBF16(約1テラバイト)に加え、米NVIDIAのBlackwell向けNVFP4(約280ギガバイト)や、HopperおよびAmpereシリーズに適したFP8が用意された。B200 GPUを4基使用することで、長文脈や同時リクエストを処理可能なメモリ領域を確保して運用できる。公開初日からtransformers、vLLM、SGLangの各ライブラリに対応し、DFlash2を用いたdecoding" title="動作が軽くて速い小型AIが文章の続きを素早く下書きし、賢い大型AIがそれを一括で確認・修正することで、文章生成を大幅に速くする技術。">投機的デコーディングによる高速生成もサポートする。
自社データへの適応手段としてLoRAを用いた教師あり微調整(SFT)や強化学習の手法も提示された。提示された多言語思考タスクの検証では、基底モデルが16問中3問にとどまった指示言語での推論を、微調整後は16問すべてで達成した。Reflectionは、Beamを活用してデモやデータセットなどを制作した優れたプロジェクトに対し、総額1万ドルのHubクレジットを付与する企画も実施している。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
