第11回 マルチモーダル
画像・音声・動画を扱うAI
- マルチモーダルとは何か (文字以外の情報もまとめて扱えること)
- 画像や音声も「トークン」に変えて、同じしくみで扱う
- 仕事での使いどころと、見間違い・写り込みへの注意
文字だけのAIから、見て聞くAIへ
初期のチャットAIが扱えたのは文字だけでした。いまの生成AIの多くは、写真を見せて質問したり、声で話しかけたり、動画の内容を説明させたりできます。このように、文字・画像・音声・動画といった複数の種類の情報をまとめて扱えることを、マルチモーダルと呼びます。「モード」は情報の種類のことです。
ホワイトボードを撮った写真から会議のメモを作る、グラフの画像を読んで傾向を説明させる、会議の録音から議事録を作る。どれも、文字だけのAIではできなかった使い方です。
しくみ: 何でも「トークン」に変える
第6回で、AIは文章をトークンという小さな単位に区切って読んでいることを見ました。マルチモーダルAIは、画像や音声も同じように扱います。
画像は小さな区画に分けて、区画ごとに数値の並びに変えます。音声は短い時間ごとに区切って、同じように数値の並びにします。いったん同じ形にそろえてしまえば、文字のトークンと並べて、1つのモデルでまとめて処理できます。そのため、「このグラフの赤い線は何を表していますか」のように、画像の中の一部分と言葉を結びつけて考えることができるのです。画像と文章を一緒に扱うモデルは、視覚言語モデル(VLM)とも呼ばれます。
出力の側も同じで、文章で答えるだけでなく、画像を作ったり、声で話したりできるモデルもあります。どの入力と出力に対応しているかは、サービスによって違います。
仕事での使いどころ
いちばん手軽なのは、写真から文字や情報を読み取る使い方です。手書きのメモや紙の資料を文字にする、現場の写真から点検記録の下書きを作る、パソコンの画面を撮って「この操作はどうすればいいですか」と聞く。音声の側では、会議の録音を文字に起こす音声認識と、要約を組み合わせる使い方が広まっています。
ほかにも、外国語の説明書や表示の写真を撮って訳してもらう、お客様から届いた不具合の写真を見て状況を整理する、手書きの図や画面のスケッチから資料の下書きを作るといった使い方があります。言葉にしにくい情報ほど、見せる効果が大きくなります。
たとえるなら
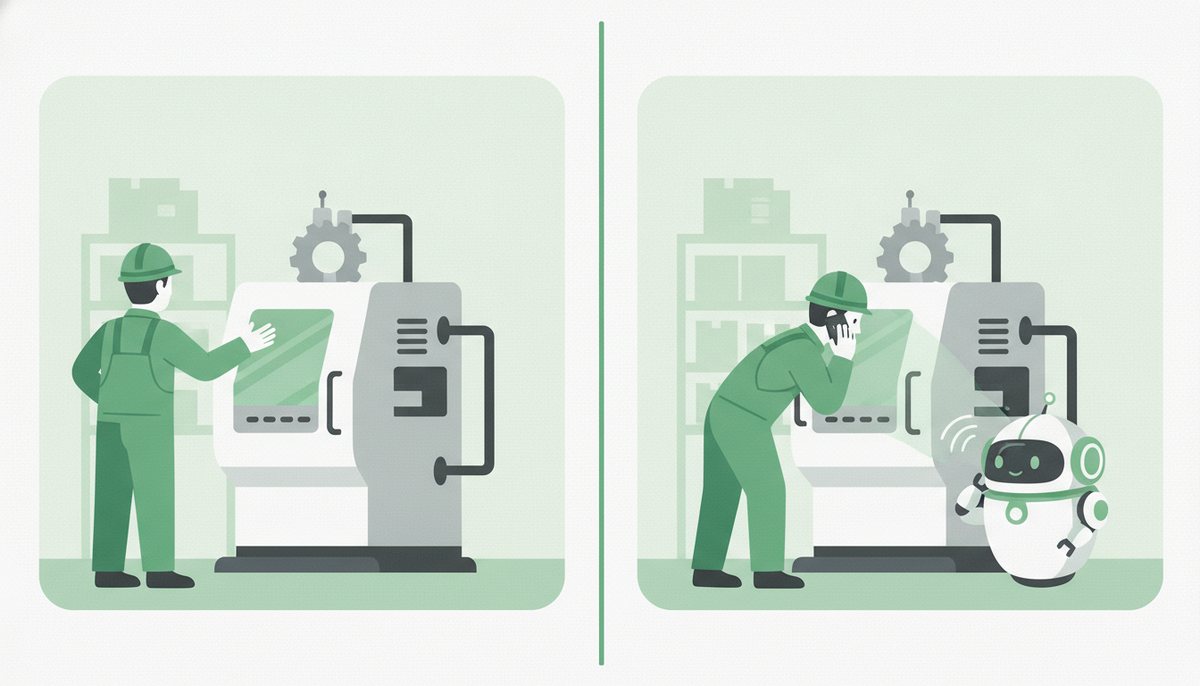
これまでは、電話でしか相談できない相手に、目の前の機械の様子を言葉だけで説明していたようなものでした。マルチモーダルAIは、その相手が隣に来て、一緒に機械を見て、音を聞いてくれるようになった状態です。「うまく説明する」代わりに「見せる」「聞かせる」ことができるので、伝わる情報の量が大きく変わります。
注意したいこと
画像を扱えても、見間違いは起きます。小さな文字や崩れた手書き、細かい表、写っているものの数を数えることなどは、今でも間違えやすい場面です。グラフの読み取りでも、目盛りの細かい数値を取り違えることがあります。第8回のハルシネーションと同じように、読み取った数字や名前は、元の写真や実物で確かめましょう。
もう一つは個人情報です。写真には、思った以上に多くの情報が写り込みます。書類に書かれた名前や住所、人の顔、後ろに映ったパソコンの画面。AIに渡す前に、写り込んだ個人情報がないかを確かめ、必要なら撮り直すか、その部分を隠してから渡しましょう(第22回)。
ニュースを読むコツ
「〇〇がマルチモーダルに対応」というニュースを見たら、何を入力できて、何を出力できるのかに注目してください。画像を「見る」だけなのか、声で会話できるのか、画像や動画を「作る」こともできるのか。同じ言葉でも、できることの幅はモデルによって大きく違います。声で会話できるものなら、返事がどれくらい自然な間合いで返ってくるかも、使い心地を左右する大事な点です。
やってみよう
手元にあるものを撮って、AIに見せてみましょう。家電のリモコン、食品のパッケージの裏、本の表紙など、文字が書かれたものがおすすめです。名前・住所・顔・パソコンの画面など、個人情報が写り込まないものを選んでください。
- 写真を添えて「この写真に写っているものは何ですか。書かれている文字も、できるだけそのまま読み取ってください。」と送ってください。
成功の目安: 写っているものの名前が当たり、書かれた文字が読み取られていれば成功です。実物と1文字ずつ見比べて、読み間違いがないかも確かめてください。
- 同じ会話の続きで「写真の中で、読み取りに自信がない部分や、見えにくい部分はどこですか。」と聞いてみてください。
成功の目安: AIが挙げた部分を実物で確かめて、文字が小さい・かすれている・光が反射しているなど、本当に読みにくい部分であれば成功です。1回目の答えのうち、その部分に間違いがなかったかも見てみましょう。
確認クイズ
Q1. マルチモーダルとはどういう意味?
- 複数のAIを同時に動かして、作業を分担させること
- 1つの文章を、複数の言語に翻訳できること
- 文字だけでなく、画像・音声・動画など複数の種類の情報をまとめて扱えること
答えを見る
正解は C。「モード」は情報の種類のことです。写真を見せて質問したり、声で話しかけたりできるのが、マルチモーダルなAIです。Q2. マルチモーダルAIが画像を扱うしくみとして、本文で説明したのはどれ?
- 画像を小さな区画に分けて数値の並びに変え、文字のトークンと同じように扱う
- 画像の色の平均だけを読み取って、何が写っているかを当てる
- 画像を人間がいったん文章で説明し直してから、AIに読ませる
答えを見る
正解は A。画像も音声も、いったん数値の並びにそろえれば、文字のトークンと並べて1つのモデルで処理できます。だから画像の一部分と言葉を結びつけて考えられます。Q3. 写真をAIに渡すときの注意として、本文で挙げたのはどれ?
- 書類の名前や後ろに映った画面など、写り込んだ個人情報がないか確かめる
- 写真は必ず白黒にしてから渡す
- 1枚ずつではなく、必ず動画にして渡す
答えを見る
正解は A。写真には、思った以上に多くの情報が写り込みます。渡す前に確かめ、必要なら撮り直すか、その部分を隠してから渡しましょう。この回に関係する最近のニュース
- BoxとNVIDIAが連携拡大、社内情報を使ったAIの応答速度を4倍に向上
- 米Ai2、ロボットの失敗原因を突き止める模擬空間を公開 データ生成も自動化
- 音声認識AIの性能比較にエジプトとナイジェリアの英語が追加、評価の偏りを防ぐ

