機密20億件をAIに丸ごと検索させる!? 米Octaveが築いた防壁の正体
- Octaveは製薬などの規制産業向けに、厳格なデータ隔離を保ちながら20億件の文書を扱うAI基盤を構築した。
- Bedrockの画像・多言語対応モデルや仮想マシン技術を活用し、機能ごとの開発導入期間を50%短縮させた。
- 外部ファイルの不審な指示を防ぐ多層防御や個人情報保護を施し、苦情対応の自動化から本番稼働を開始した。
他社の不具合情報や是正措置、監査記録がひとたび混ざれば即座に重大な規制違反に問われる製薬や医療機器の世界。そんな極めてシビアな規制産業において、20億件を超える膨大な文書を共通のAI基盤で安全に検索できる仕組みを構築したという。いくら便利とはいえ、顧客データが隣り合うマルチテナントで本当に情報漏洩のリスクはないのか。話がうますぎるのではないか、と疑いたくもなる。
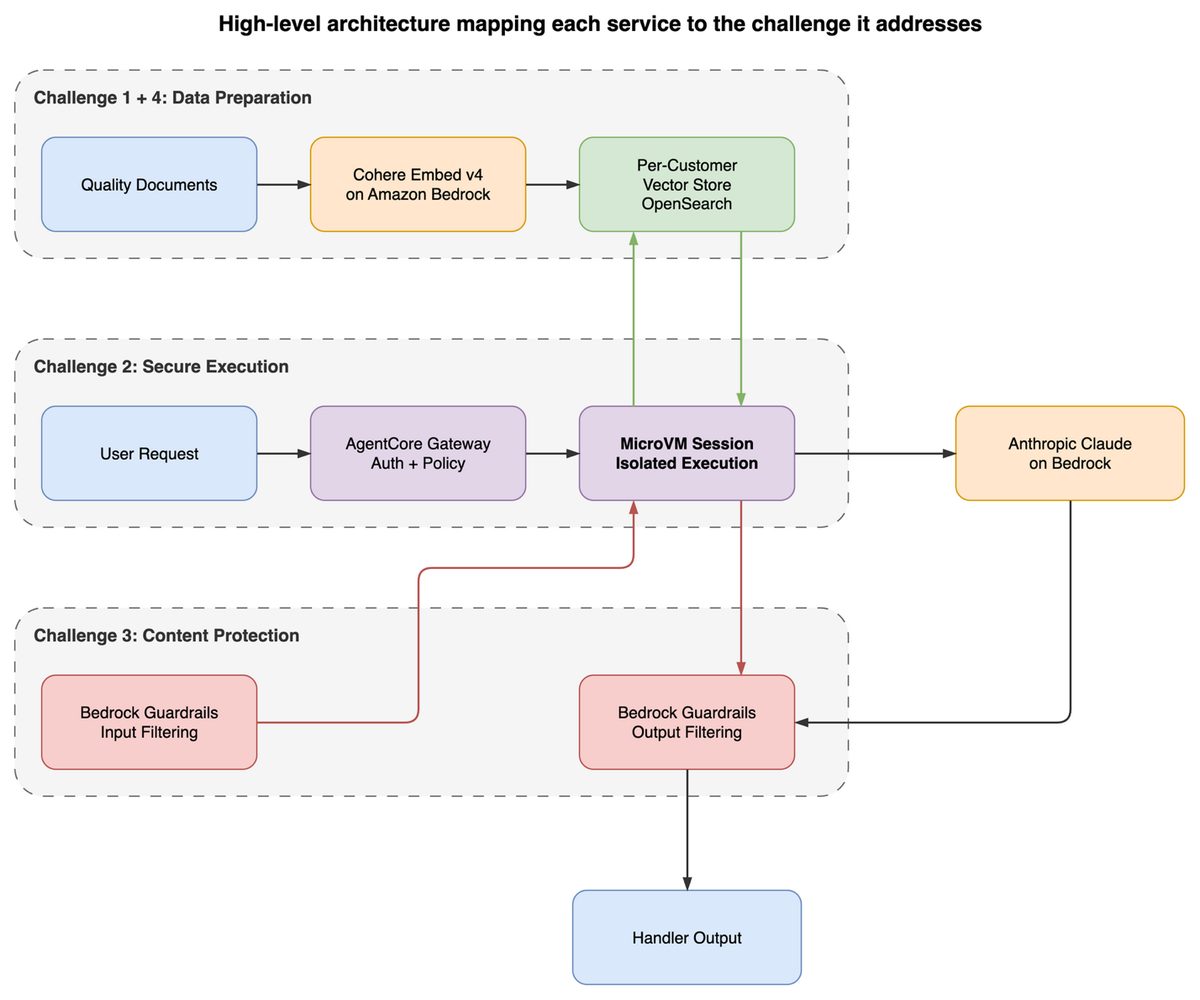
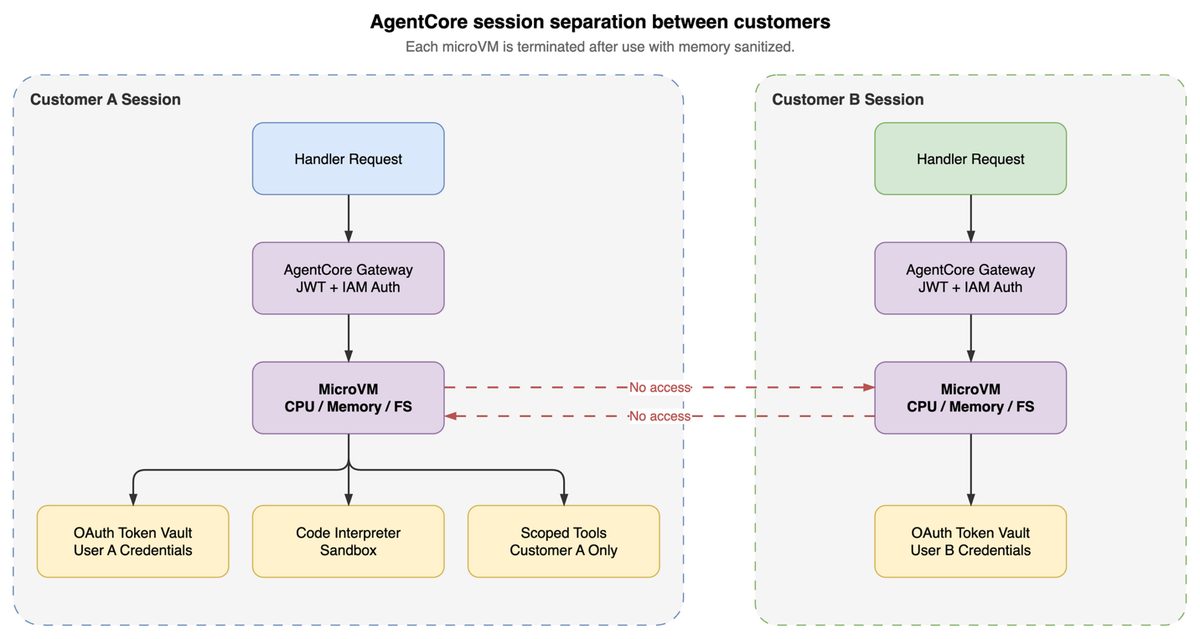
だが、公式発表の一次情報を紐解くと、極めて強固な技術的裏付けが見えてくる。手がけたのはクラウド品質管理大手の米Octaveだ。180カ国・1万4000社以上を抱える同社は、Amazon Bedrock上に共通AI基盤を構築した。各セッションを専用の軽量仮想マシン(microVM)内で独立実行させ、終了時にメモリを完全消去するハードウェアレベルのデータ分離を実現。さらに悪意ある指示を防ぐガードレール機能や個人情報のマスキングなど多層の防御壁を張った。画像と文章を同時検索できるモデルの採用でコストを約66%削り、開発期間も半減させた上で、まずは苦情トリアージ支援から本番稼働させたというのだ。
ここからは編集部の推測だが、規制が厳しい大手企業を納得させられた最大の勝因は、個別の機能ごとにAIを作るのではなく、最もリスクが高いインフラの土台で「物理的な使い捨て環境」に近い隔離方式を確立した点にあるとみられる。セッションごとに痕跡を残さない徹底したクリーンアップ構造があったからこそ、慎重な製薬企業などのセキュリティ基準を突破できたと考えるのが自然だ。
現時点で確かなのは、強固な防壁とコスト削減を両立させた基盤が動き出し、最初の用途で成果を出し始めたことまでだ。今後は監査監視やリスク予測など、さらに機微な領域への拡大が予告されている。複雑な業務へ広げた際にもこの鉄壁の安全性が保たれるのか、真価が問われるのはこれからだ。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
