アマゾンのAI半導体で無駄を可視化、計算のまとめ処理で速度が約6倍に
- AWSのAI半導体向けに、深層学習フレームワークの処理遅延を体系的に分析する手法が解説された。
- 代表的な演算処理の比較検証では、処理を1つに統合することで機器側の実行時間が約6分の1に短縮した。
- 分析ツールで機器の待機時間を把握でき、今後は半導体内部の詳細な負荷を調べる手順が示される予定だ。
学習させる手法。2010年代のAIブームの原動力。">深層学習モデルの動作が遅い原因を体系的に分析し、処理時間を特定するためのプロファイリング手法が公開された。深層学習の学習や推論向けに設計されたアマゾン ウェブ サービス(AWS)のAI半導体「AWS Trainium」と、オープンソースのPyTorchバックエンド「TorchNeuron」を対象に、性能分析ツールを用いた検証手順が示されている。
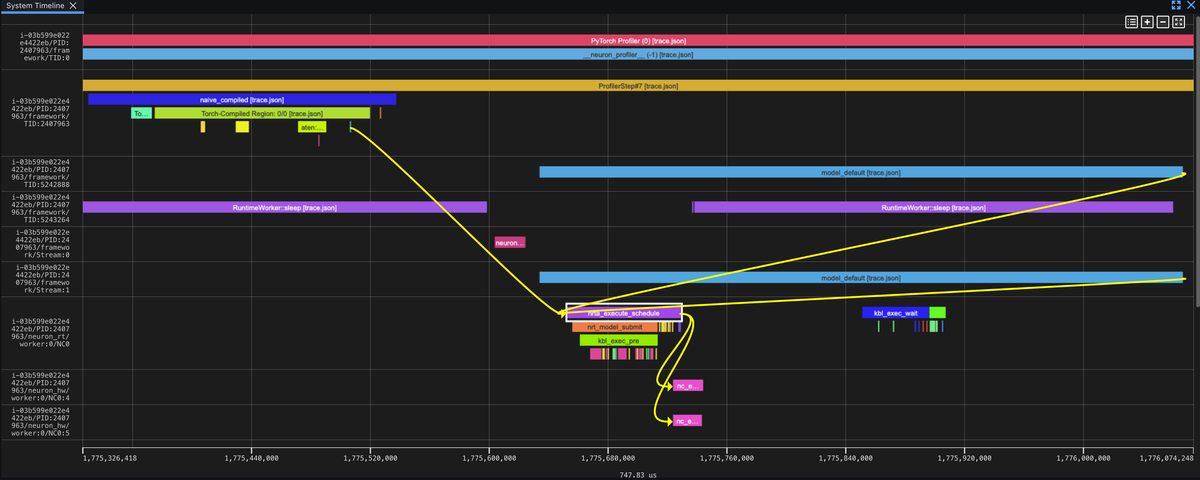
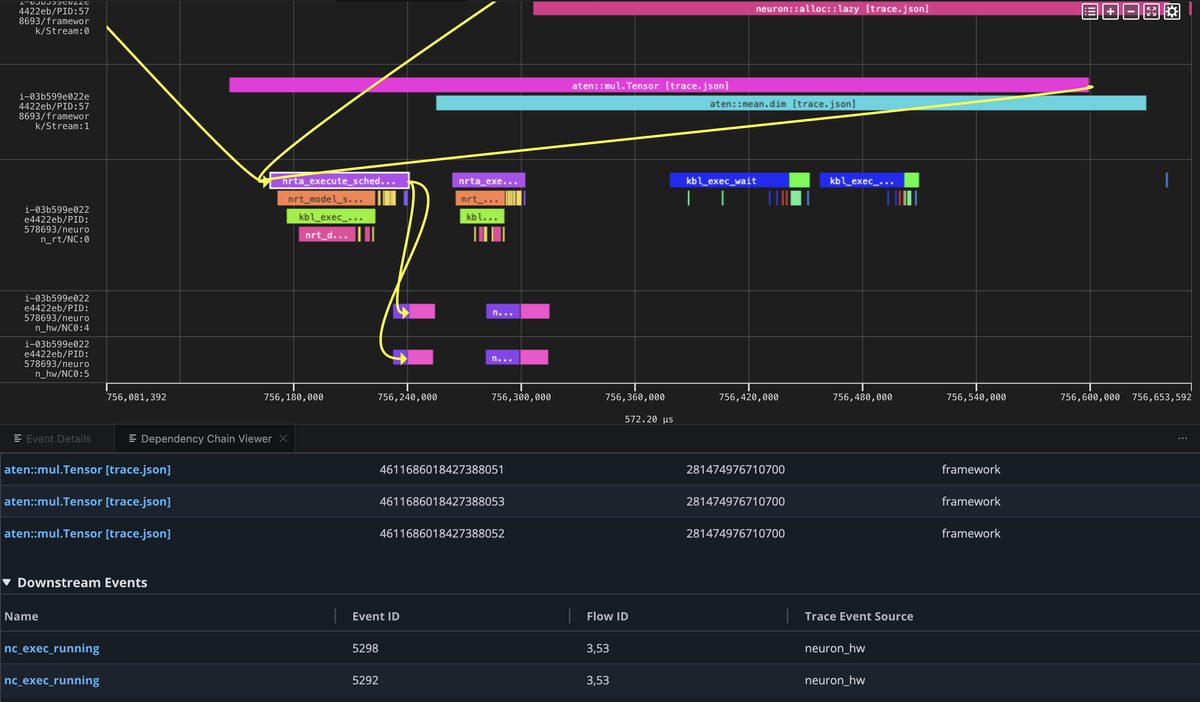
モデルを高速化する直感を持っていても、遅延の根本的な原因を正確に分析できる開発者は多くないという背景がある。Neuronバックエンドは、PyTorchの「PrivateUse1」拡張機構を利用して上流のPyTorchと連携しており、専用の処理振り分けキーを追加することなくネイティブバックエンドとして登録されている。分析にあたっては、「NeuronConfig」で取得するデータストリームやコアを指定し、「NeuronProfiler」を介して出力を行う。ブラウザ上で動作する「Neuron Explorer」を用いることで、フレームワークからの処理投入からランタイムのスケジュール、ハードウェア上での実行までの時間経過を視覚的に追跡できる。
検証では、算術演算と集約処理が明確に連なる「RMSNorm」を取り上げ、3種類の実装方式で挙動の違いを比較した。1つ目は個別の演算を順番に呼び出す素朴な実装、2つ目は組み込み関数「torch.rms_norm」を用いて単一の統合カーネルに落とし込む実装、3つ目は「torch.compile」を用いて素朴なコードをコンパイラ経由で自動統合する実装である。測定は準備期間などを除く4回のステップ(待機2、ウォームアップ1、アクティブ1)で行われた。
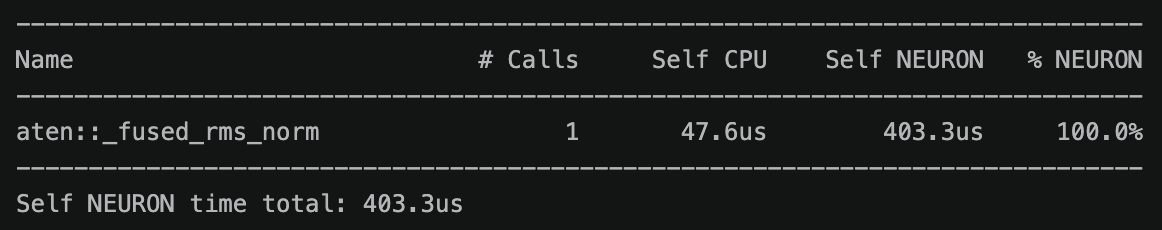
個別の演算を逐次実行する素朴な実装では、掛け算処理が機器時間の大部分を占め、演算ごとにフレームワークからハードウェアへの伝達が発生していた。これに対し、組み込み関数の利用やコンパイルによる統合を行った実装では、一連の計算が1回のハードウェア処理としてまとめられた。測定結果では、素朴な実装に比べて統合処理を行った場合の機器実行時間が約6分の1に短縮した。具体的な数値として、「torch.compile」の実行時間は375マイクロ秒、「torch.rms_norm」は403マイクロ秒と同等の高水準を記録した。処理を統合することで、ハードウェア実行の合間に生じる隙間がなくなり、中間データの生成も回避できることが性能向上につながっている。
今後は第2段階として、コンパイル後の実行ファイルを直接確認し、内部の演算エンジンやデータ転送の内訳を調べて計算限界かメモリ転送限界かを評価する、より深いデバイスレベルの分析手順が扱われる予定である。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
