AWSの独自半導体で文章生成AIを効率よく学習、3つの手法を公開
- AWSのAI向け半導体「Trainium」とPyTorch向けツールを使い、Qwen3を学習させる手法が示された。
- 既存の公開データを直接読み込む方法や、処理を最適化する部品を組み込む3種類の手順を解説した。
- 1台のサーバー内で64個の演算部へモデルを分散配置し、メモリ消費を抑えながら学習できる。
AWSは、自社のAI特化型半導体「AWS Trainium」向けに、PyTorchの学習を高速化するため、複数のコンピュータや計算用チップに処理を分担させて同時に計算を進める手法。">分散学習フレームワーク「torchtitan」を用いて言語モデル「Qwen3」を学習させる手順を公開した。TorchNeuronがTrainiumをネイティブなPyTorchデバイスとして認識するため、開発者は標準的なインターフェースを通じて、単一の「trn2.48xlarge」インスタンス上で3通りの学習構成を実行できる。
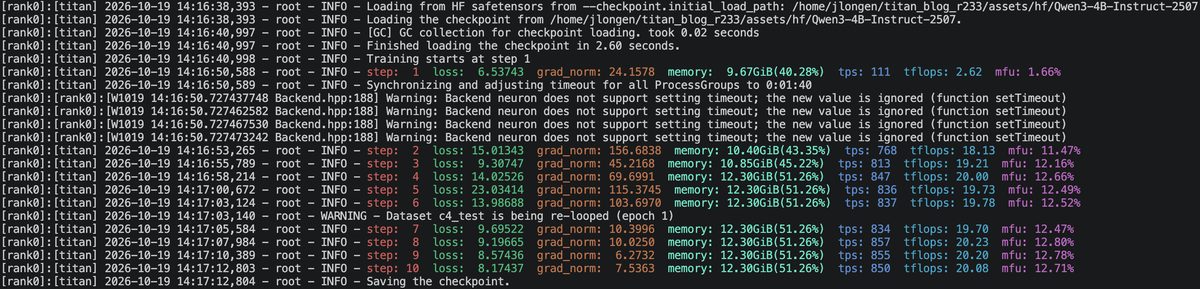
1つ目の手法は「生成AIの土台になっている仕組み。文中の単語同士の関係を一度に見渡せるのが特徴。">Transformers v5」をモデリングバックエンドとして利用し、Hugging Face Hubのモデル定義や公開済みのsafetensors形式の重みを直接読み書きする方法である。検証では「Qwen/Qwen3-4B-Instruct-2507」の重みを読み込んだ際のステップ1の損失が6.54となり、ランダム初期化時の12.43と比較して正常に重みが読み込まれたことが確認された。2つ目の手法では、設定を変更してtorchtitanが備えるネイティブなQwen3実装に切り替えて学習を行う。
3つ目の手法は、Neuron専用のカーネル記述言語「Neuron Kernel Interface (NKI)」を用いたMixture-of-Experts (MoE) カーネルの導入である。検証例では「Qwen3-30B-A3B」を4レイヤー・64エキスパートに縮小し、単一のtrn2.48xlargeに収まるよう構成している。さらに、独自のNKIカーネルを登録して既存の回転位置埋め込み処理を置き換える手順も示され、float32入力における数値検証では置き換え前後の実装間で最大絶対差が0.0となり、計算の整合性が確認された。
いずれの構成でも共通の起動手順が適用され、trn2.48xlargeが備える64個の論理NeuronCore全体にモデルが分散配置される。データ並列やテンソル並列を組み合わせることで、モデル規模やシーケンス長に応じた高帯域メモリ (HBM) の使用量を管理しながら学習を進められるとしている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
