IBMの予測AIを4種束ねて未来予測のブレを低減 再学習なしで利用可能に
- 特性が異なる4つの事前学習済みモデルを束ね、単一モデルを選ぶ手間や予測精度のブレを軽減する手法を公開した。
- 均等に重み付ける手法と予測幅に応じて動的に重みを変える2種類を用意し、追加学習なしで即座に予測できる。
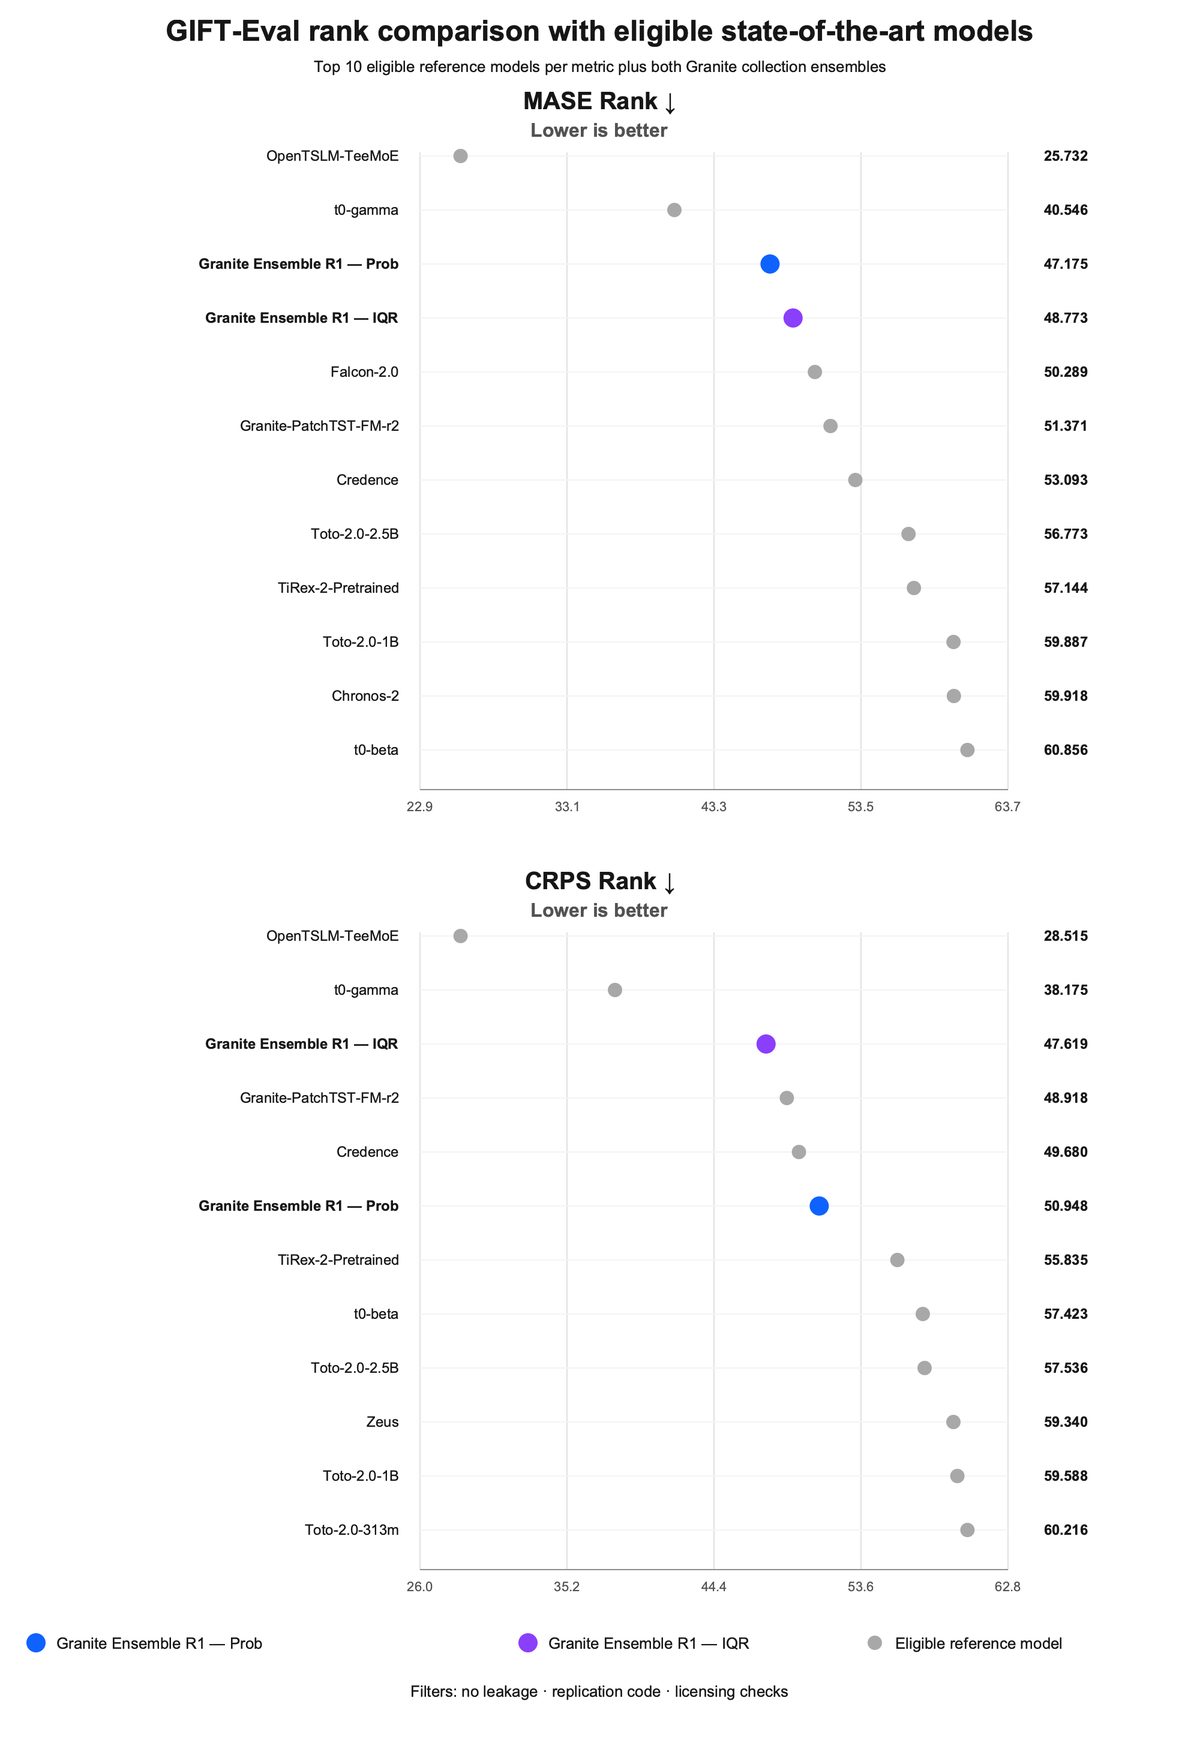
- 97通りの評価データで単一モデルを超える総合精度を記録し、適格な比較対象の中で3位の成績を収めた。
IBMとHugging Faceは、学習工程。数か月と巨額の計算費がかかる。">事前学習済みの時系列モデル4種類を組み合わせて予測を行う統合環境「Granite Timeseries Ensemble」を公開した。データセットごとの追加学習やモデルの重み結合を行わずに、単一のインターフェースから代表値と予測範囲を出力できる仕組みを提供する。コードおよび基本構成モデルは寛容なオープンソースライセンスで提供される。
時系列予測では、滑らかな産業データに適したモデルがノイズの多い小売需要や長期の季節変動に適合しないなど、対象データごとに最適な構造が異なる課題があった。今回の取り組みは複数の気象予測モデルを組み合わせる気象予報の手法に着想を得ており、50年にわたる予測統合の研究知見に基づき、単一のモデルを選び損ねるリスクを低減する設計となっている。
標準レシピでは、「PatchTST-FM-r1」「PatchTST-FM-r2」「FlowState」「Tiny Time Mixers」という構造の異なる4つのモデルを同時実行する。統合手法には、各モデルの予測分布を等しい影響力で重ね合わせる「Probabilistic Ensemble」と、予測幅が狭く信頼度が高いとみなせるモデルの比率を動的に高める「IQR Ensemble」の2種類を用意した。いずれの手法も点予測だけでなく、0.1から0.9までの分位点予測を出力し、80%の予測区間などを算出できる。
97種類の構成を含む評価指標「GIFT-Eval」で検証したところ、2026年10月20日時点の集計において、Probabilistic Ensembleの平均絶対スケーリング誤差(MASE)は0.683を記録した。これは単独で最良だったPatchTST-FM-r2の0.685を上回り、適格な公開モデルの中で総合3位にランクインした。個別のモデルで最高精度を出すことよりも、事前の検証なしに幅広いデータに対して安定した予測性能を引き出せる堅牢性が強みとされている。
一方で、4つのモデルを同時に読み込むため単一モデル利用時よりもメモリ使用量や推論時間が増加する点や、多変量データをチャネルごとに独立して処理する制限がある。また、IBM Researchが提供する追加のモデルチェックポイントを利用する場合には非商用などの個別ライセンス条件が適用されるため、導入前の確認と代表データでの事前検証が推奨されている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
