音声読み上げAIのサーバー自動増減を勘に頼らず最適化 AWSが実測手法を公開
- AWSはSageMaker AI上の音声合成モデル向けに実測値で自動増減しきい値を決める手法を公開した。
- 1台あたりの最大並行処理数と増設にかかる所要時間を実測し、計算によって設定値を自動導出する。
- 実機検証では許容並行数50を特定し、勘によるコスト浪費やアクセス急増時の遅延悪化を防ぐ。
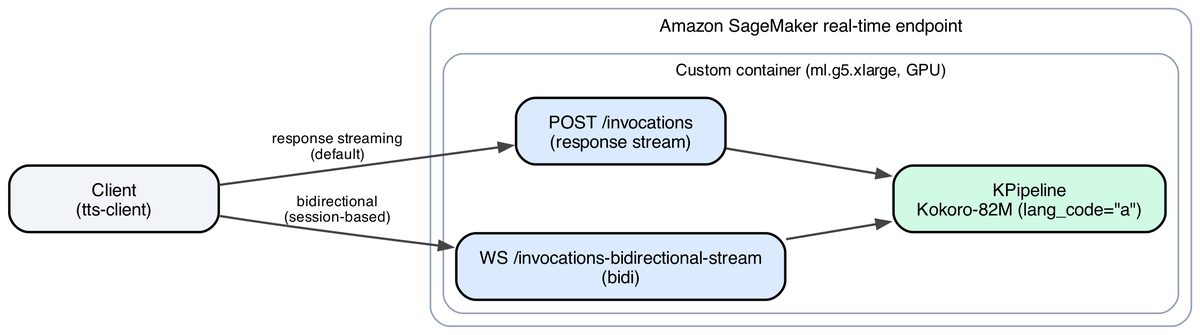
アマゾン ウェブ サービス(AWS)は、クラウド機械学習基盤「Amazon SageMaker AI」において、音声合成(TTS)モデルのサーバー自動増減(オートスケーリング)設定を勘に頼らず実測値から導出する手法とツールを公開した。
音声合成モデルは1回のリクエストで数秒間接続を保持するため、生成トークン数を基準にする大規模言語モデル(LLM)のような負荷計測手法が適用しにくい。そのため、増減しきい値の予測が外れると、GPUインスタンスが遊休状態になって無駄な費用が発生するか、アクセス急増時に処理待ち時間が増加して目標レイテンシ(SLO)を超過する課題があった。
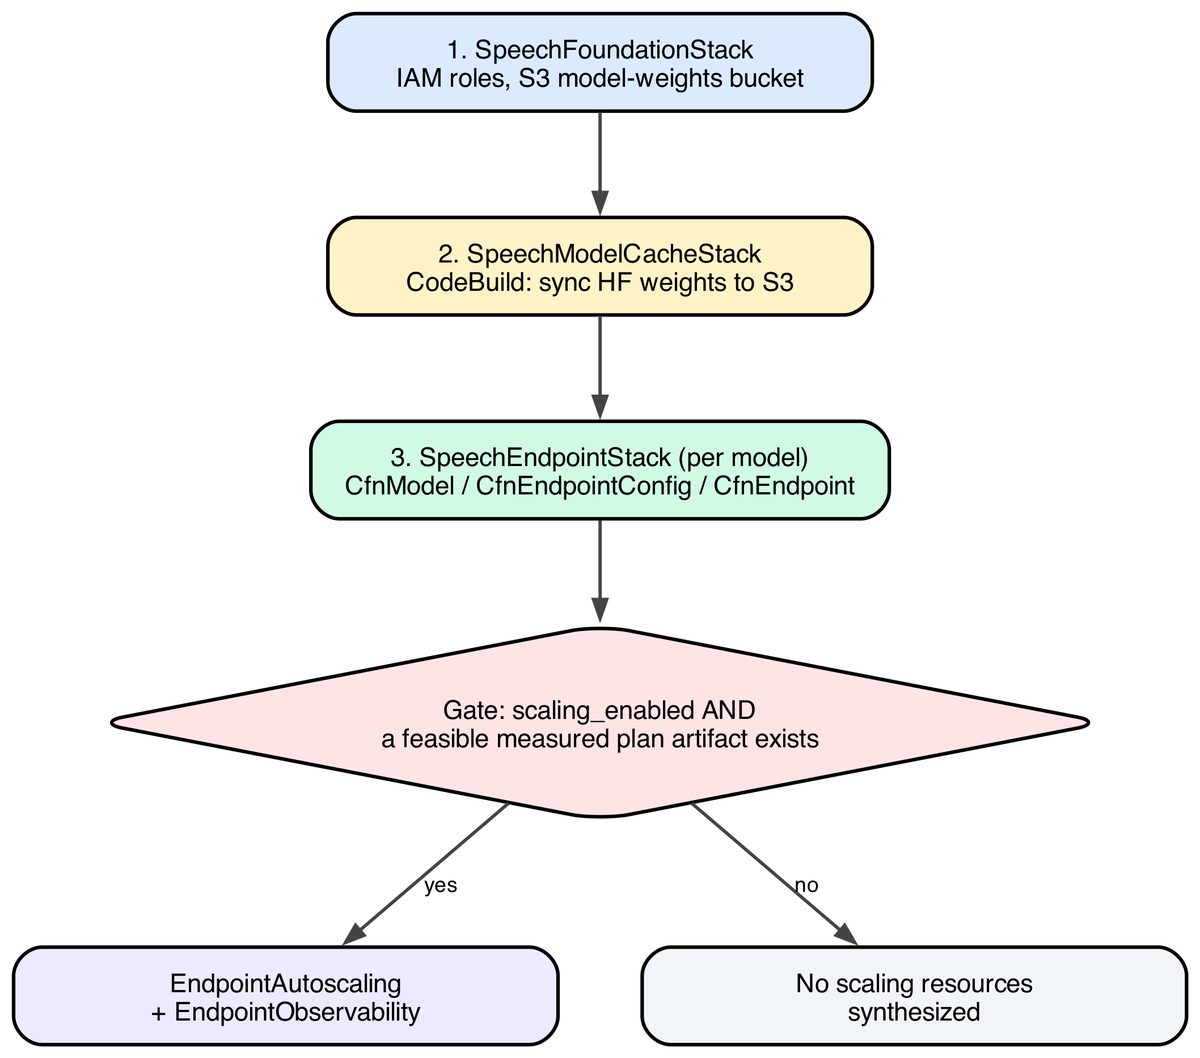
今回提示された手法では、実際のエンドポイントに対して2つの数値を測定する。1つは目標レイテンシを維持できる最大並行リクエスト数(Q_max)、もう1つはインスタンスの追加要求から正常にトラフィックを処理できるようになるまでの所要時間(T_total)である。これらの実測値から計算によって増設・縮小のしきい値と待機時間を決定する。AWS CDKによる構成を採用し、測定計画データが存在しない場合は自動増減リソースが本番環境へ反映されない制御も組み込まれている。
約8,200万パラメータの音声合成モデル「Kokoro-82M」を「ml.g5.xlarge」インスタンスで動かした検証では、目標レイテンシを維持できる最大並行数(Q_max)が50と特定された(並行数60でSLOを超過)。また、スケールアウトの所要時間は純粋なプロビジョニング計測で260.2秒(検知猶予などを加えた計画値は320.2秒)となり、そのうちインスタンス準備とコンテナイメージ取得が181秒と全体の56%を占めることが示された。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
