AIが話すまでの5秒の沈黙を短縮、文章ができるそばから声に変える新手法をAWSが解説
要点 3行
- AI音声対話では全文生成を待つと声が出るまで数秒の遅延が生じ、利用者の不満につながる課題がある。
- AWSは文が生成された順に音声へ変換する双方向ストリーミングを活用し、待ち時間を削る構成を解説した。
- 小規模な音声合成モデルを使い、1接続で複数文を連続処理することで再接続の負担をなくす工夫も示した。
Amazon Web Services(AWS)は、生成AIを活用した音声対話エージェントにおいて、利用者が音声を聞くまでの待ち時間を大幅に削減する実装手法を解説した。従来の仕組みでは、AIが複数段落に及ぶ長い回答全体を生成し終えるまで音声合成が始まらず、利用者が5秒間も沈黙を待たされる問題があった。文が1つ完成した時点で即座に音声化を開始することで、最初の発話までの遅延を最小限に抑える。
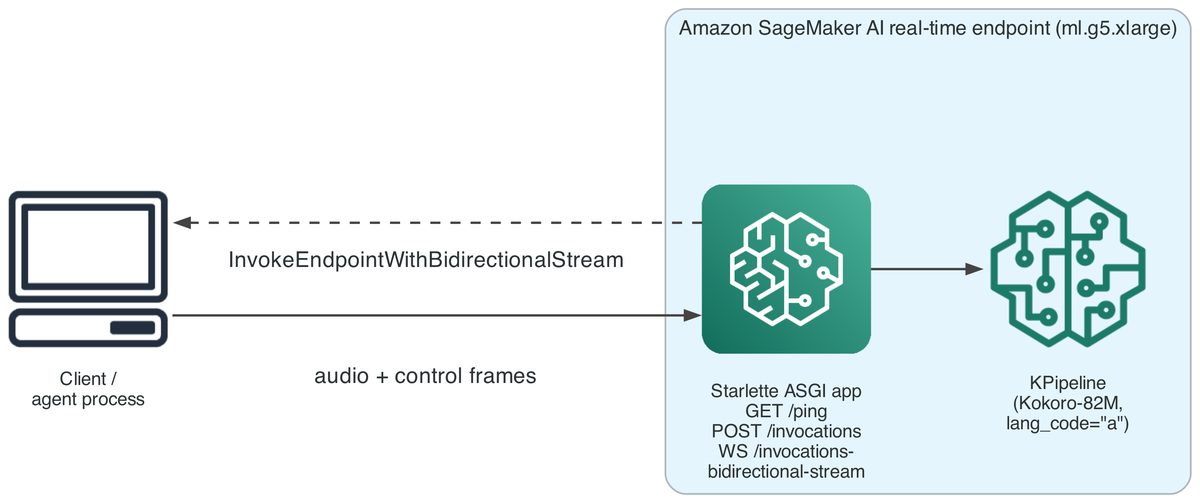
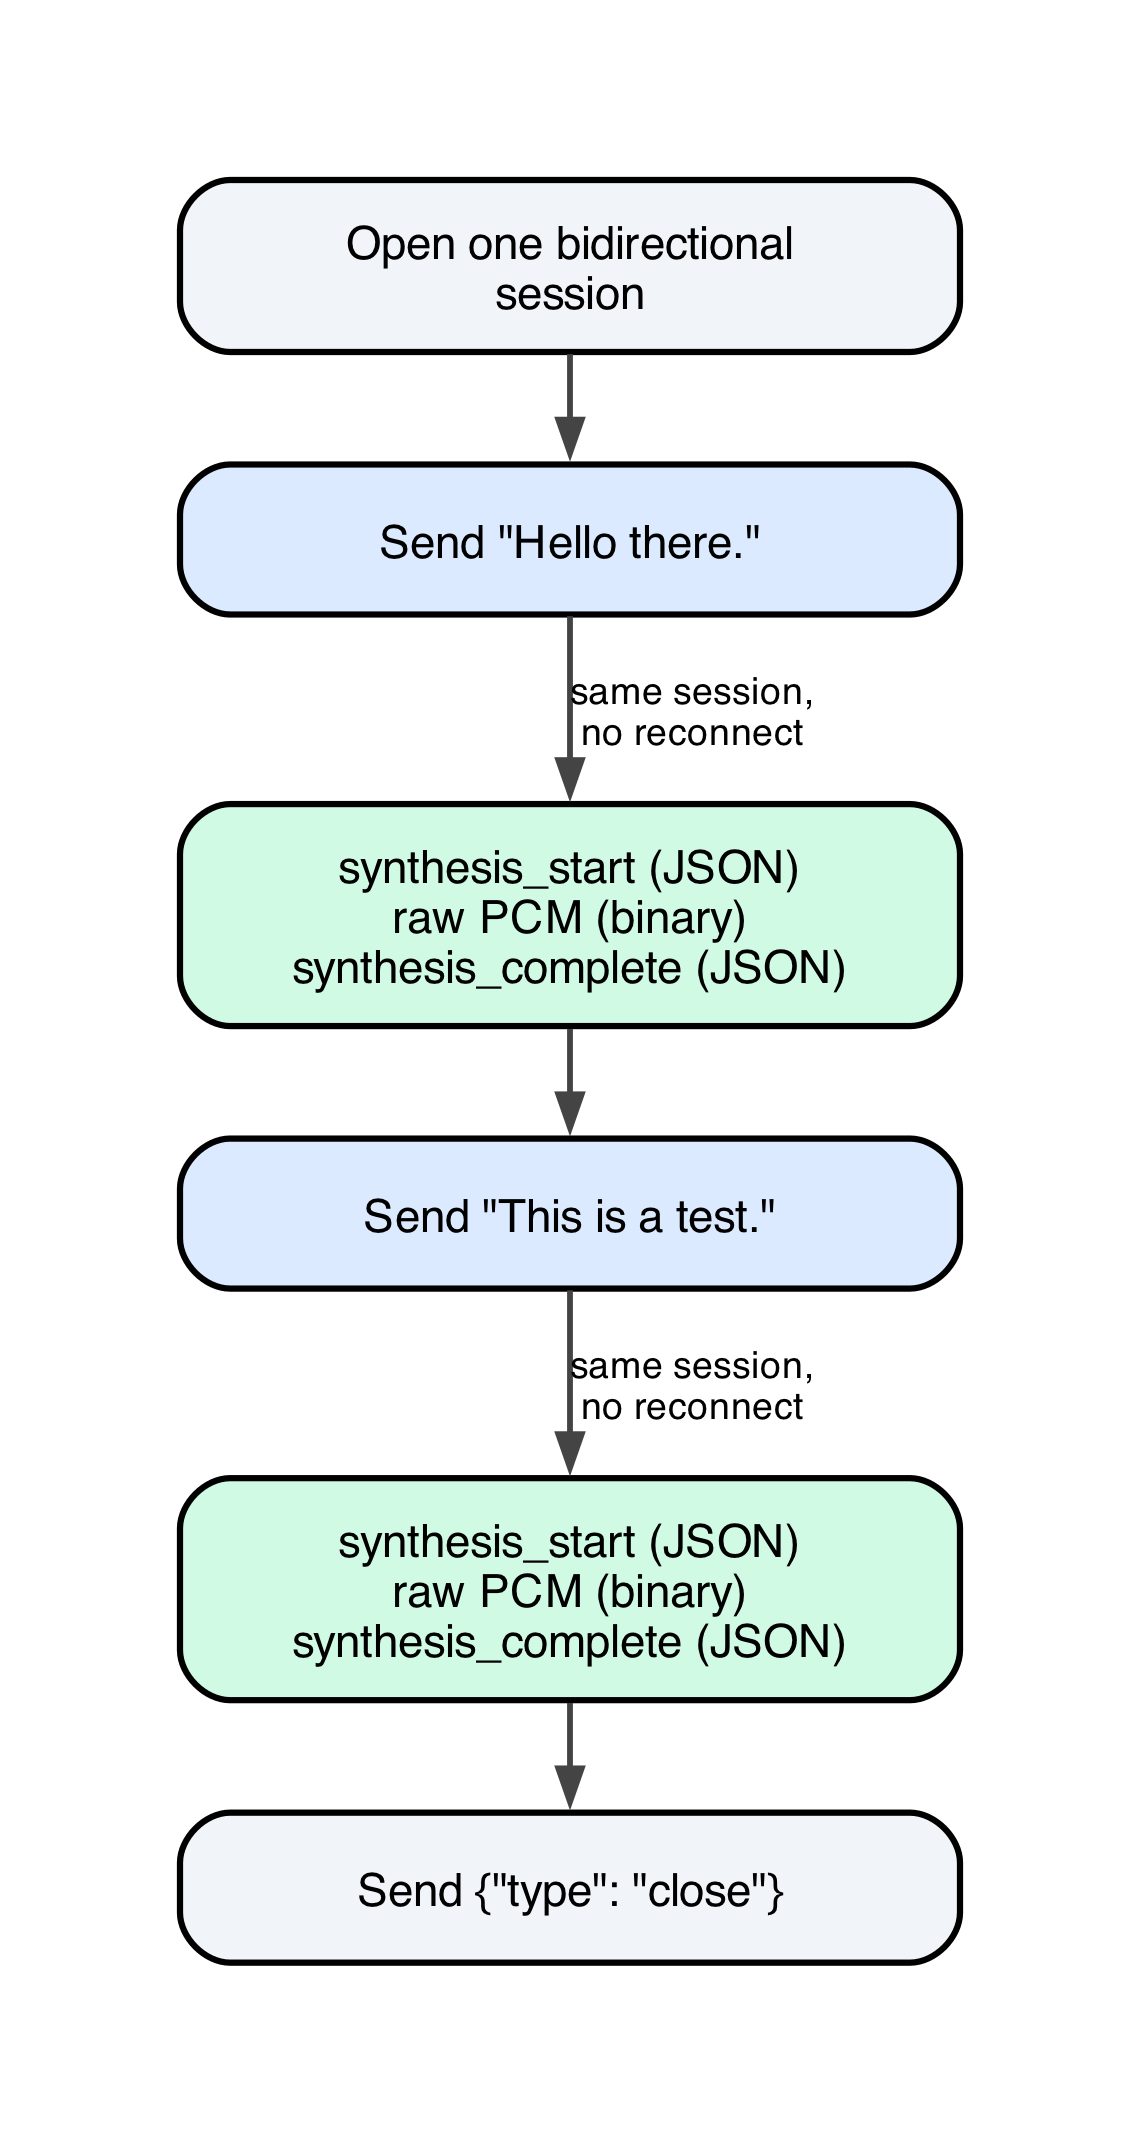
この手法では、AWSの機械学習環境「Amazon SageMaker AI」のリアルタイムエンドポイント上で、8,200万パラメータの小型音声合成モデル「Kokoro-82M」を単一のGPUインスタンス(ml.g5.xlarge)で動作させる。クライアントとの通信には双方向ストリーミングを採用し、生成された文を即座にモデルへ送信する。1文の音声化が終わっても接続を切断せず、同じセッションを維持したまま次の文を待ち受けることで、接続の再確立に伴う遅延を防止している。
生成された音声データをブラウザなどへ届ける経路についても検証が行われた。既存のウェブ環境で広く使われるServer-Sent Events(SSE)にBase64形式で音声を載せる方式では、データ量が約33%増加し、音声フレームの区切り処理も複雑化することが24個のクリップによる測定で確認された。AWSは、既存基盤を流用する場合はこの方式が現実的としつつ、遅延を最優先する場合はバイナリ音声とJSON制御フレームを同一セッションで統合処理する構成が有効だとしている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開くアプリなら毎朝1件、注目のAIニュースが届きます
記事中の専門用語をタップすると、その場で辞典の解説が開きます。無料・広告のみ。

