複数の手順を踏む作業を結果だけで効率的に学習、AWSがAI訓練手法を解説
要点 3行
- 単一指示向けではなく、複数手順の行動を結果の成否だけで学習させる強化学習手法の構築手順が公開された。
- 訓練にはサーバーレス基盤を使い、外部環境との対話と結果の点数化を通じてモデルの追加学習を実施する。
- 単語当てゲームの検証では、約339ドルの費用で正答率が61%から84%へと大幅に向上した。
Amazon Web Services(AWS)は、「Amazon SageMaker AI」上で複数ターンの対話や行動を伴う学習法。ゲームAIやロボット、推論モデルの訓練で活躍。">強化学習を実施するための実践ガイドを公開した。経費精算や問い合わせ対応など、連続した手順を踏む業務エージェントにおいて、全体の成否のみをフィードバックとしてモデルを訓練する仕組みを解説している。
従来の教師あり学習や1往復のみの強化学習では、途中のどの行動が最終結果に寄与したかを正確に評価できず、正解の手順をあらかじめ定義することも困難だった。今回の手法では正解となる行動履歴を用意する必要がなく、エージェントが一連の行動を終えた時点で得られる最終的な結果に対して報酬を与えることで、モデルを適切に更新できる。
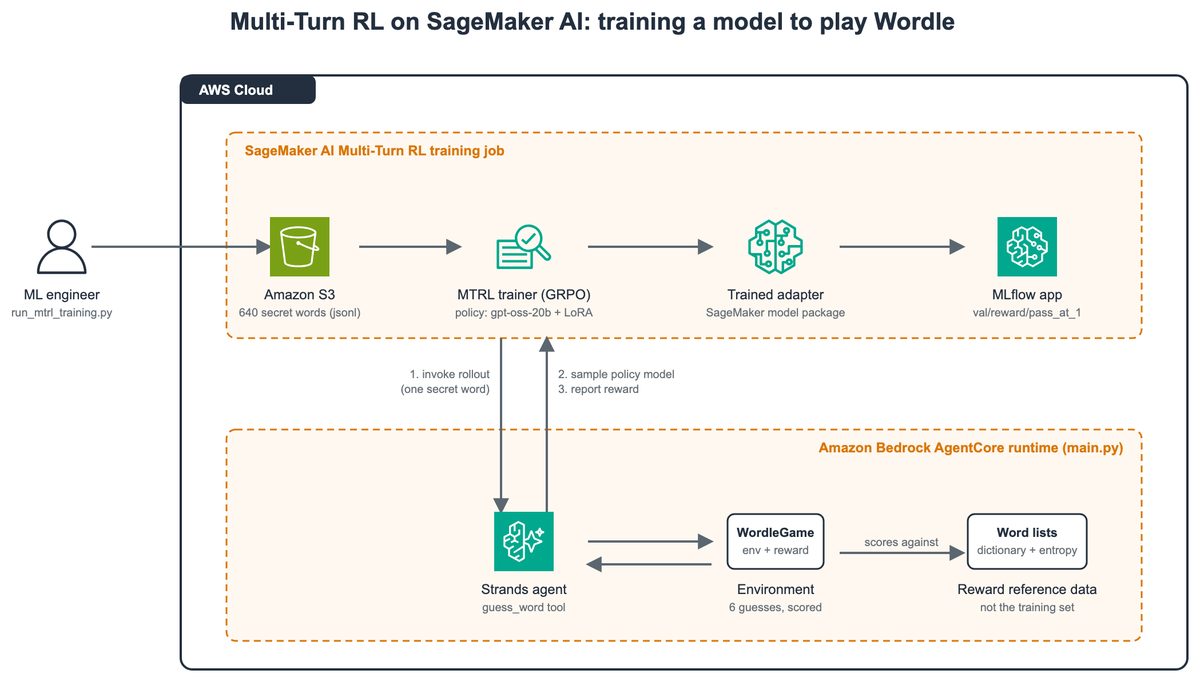
システムは、訓練処理を担うSageMaker AIと、動作環境や報酬計算を担う「Amazon Bedrock AgentCore」を連携させて動作する。モデルはツール経由で環境とやり取りを重ね、終了時に報酬を返す。基盤はサーバーレスで管理され、インスタンスの選定を要さず、処理した入力や生成などのトークン量に応じて課金される仕組みとなっている。
単語当てゲーム「Wordle」を用いた検証では、モデル「gpt-oss-20b」を用いて100ステップの学習を実施した。約339ドルのトークン費用をかけた結果、未知の単語に対する正答率は従来の61%から84%に向上した。また、計算負荷を抑えた設定においても15%から69%まで正答率が引き上げられた。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開くアプリなら毎朝1件、注目のAIニュースが届きます
記事中の専門用語をタップすると、その場で辞典の解説が開きます。無料・広告のみ。

