巨大AIを59枚の大型半導体に分散 米Cerebrasが超高速で動かす仕組みを公開
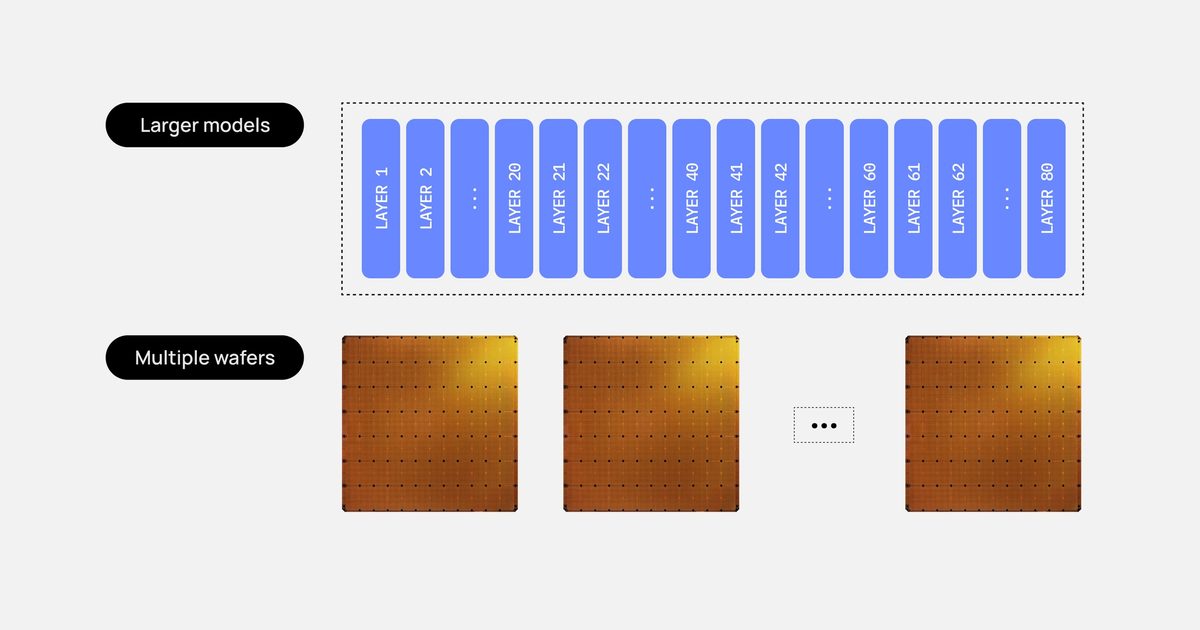
- 米Cerebrasは、3兆パラメータ規模の巨大AIモデルを複数の自社半導体へ分散して高速稼働させる手法を公表した。
- 4ビット量子化により1層を約16GBとし、キャッシュの要否に応じて59枚のウェハーへ割り振る構成を示した。
- モデルの重みを固定して中間結果のみを転送するパイプライン処理により、1秒間に1000以上の高速出力を狙う。
米Cerebrasは2026年10月25日、同社の大型半導体「WSE-3T」を複数組み合わせて、3兆パラメータ規模の巨大AIモデルを高速で推論させる技術手法を公式ブログで解説した。単一チップのメモリ容量を超える規模のモデルをウェハー間で連携させ、1秒あたり1000〜2000以上のトークン生成を実現するアーキテクチャを提示している。
同社のWSE-3Tウェハーは1枚あたり44GBのオンチップメモリを備えるが、兆単位のモデルは重みだけでテラバイト規模に達するため単体には収まらない。同社は約3兆パラメータを持つオープンソースモデル「Kimi K3」(計93層)を例示。重みを4ビットに量子化することで1層あたり約16GBとし、複数ウェハーに分散配置する計算手法を示した。
配置にあたっては層の性質を考慮する。全トークンの情報を保持するKVキャッシュを必要とする「dense層(全24層)」には、残りのメモリ領域をキャッシュ用として確保するために1ウェハーあたり1層を割り当てる。一方、文脈長に関わらず固定サイズの状態を保持する「linear-attention層(全69層)」はキャッシュ追加領域が不要なため、1ウェハーに2層(計32GB)を配置できる。これにより、合計59枚(35枚+24枚)のウェハーで全モデルを収容できると試算した。
各ウェハー間はRDMA over Ethernetで接続され、ホップ間の遅延は約2マイクロ秒にとどまる。ウェハー上の重み自体は移動させず、中間結果(アクティベーション)のみを順次渡していくパイプライン処理を採用した。各ステージで異なるリクエストを同時に処理することで、待ち時間を生じさせずに並行処理を維持する仕組みだ。なお、例示されたKimi K3は「Terminal-Bench 2.1」で88.3%(GPT-5.6 Solは88.8%)、「BrowseComp」で91.2%(GPT-5.6 Solは90.4%)の性能を示すとしている。
この記事は cerebras.aiの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
