AWS、複数マシンを束ねるAI学習の準備済み環境を公開 面倒な構築作業を不要に
- AWSが分散学習フレームワークRay Train向けの事前構築済み深層学習コンテナ(DLC)を公開した。
- 高速通信EFAやCUDAなどの依存関係が検証済みで提供され、利用者が独自にイメージを構築する手間を省ける。
- Amazon EKS上で動作し、Qwen2.5-1.5Bモデルを用いた複数ノードでの分散学習手順も示された。
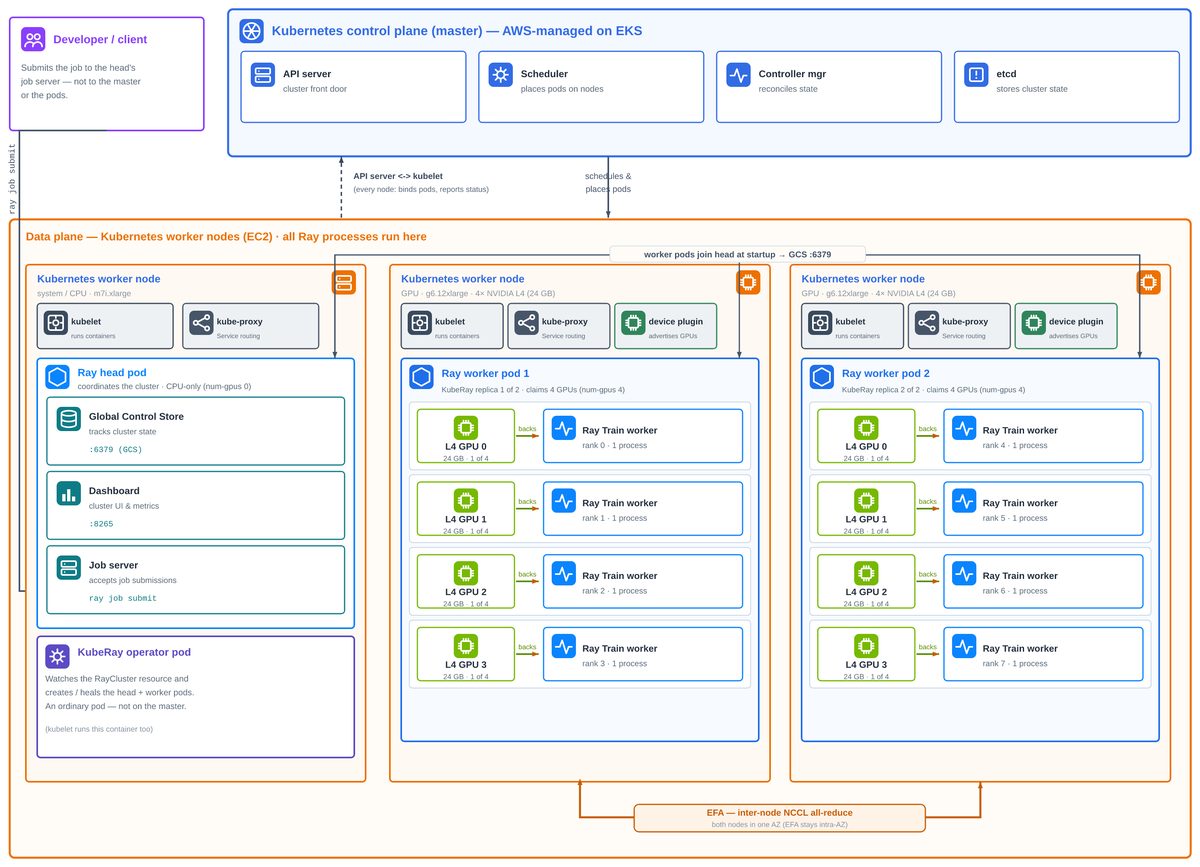
AWSは、学習を高速化するため、複数のコンピュータや計算用チップに処理を分担させて同時に計算を進める手法。">分散学習フレームワーク「Ray Train」を利用したマルチノード学習向けの事前構築済みコンテナイメージ「Ray Train Deep Learning Container(DLC)」を公開した。Amazon EKS上でKubernetesオペレーター「KubeRay」や同社の高速通信基盤「Elastic Fabric Adapter(EFA)」と連携し、複数ノードにまたがる大規模な機械学習モデルの訓練を円滑に進められる構成を提供する。
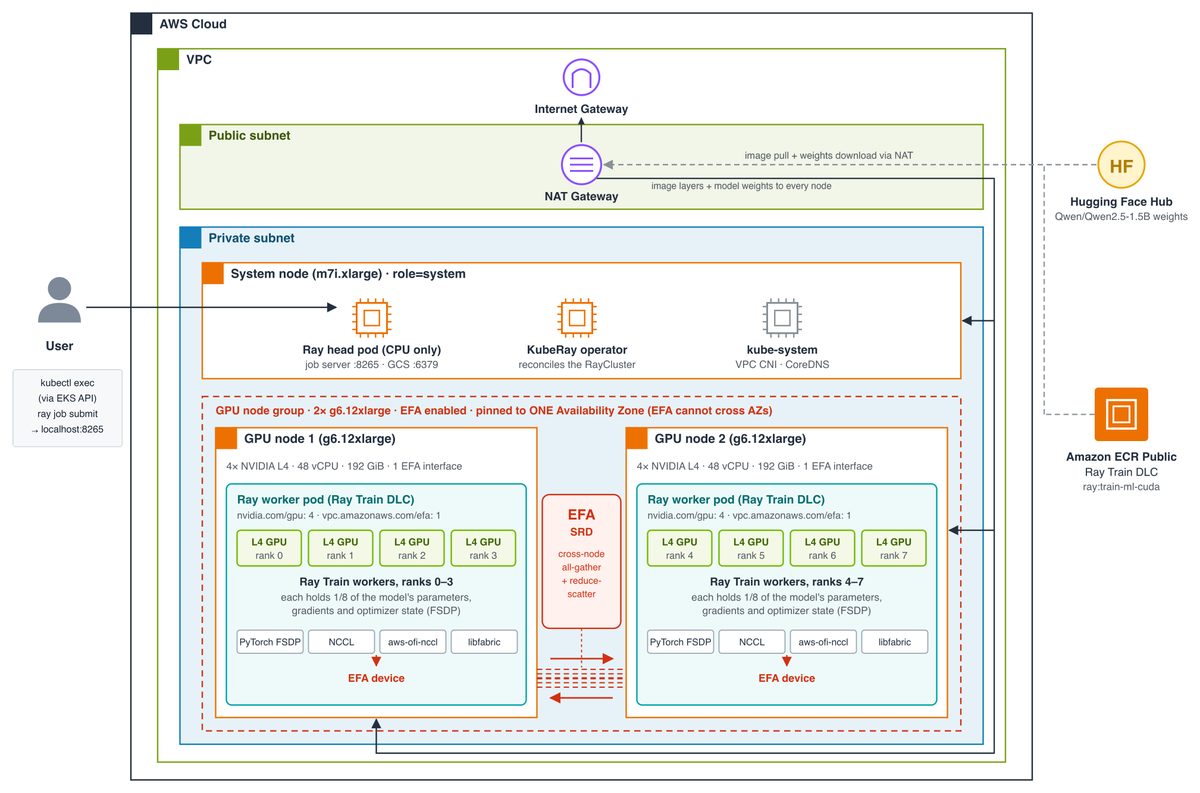
従来、PyTorchを用いたマルチノードの分散学習では、CUDAやPyTorch本体、通信ライブラリのNCCL、EFAのユーザー空間ライブラリ、AWS OFI NCCLプラグインなどの整合性を保ったコンテナイメージを自前で構築・保守することが開発者の大きな負担となっていた。ライブラリ間に不整合があるとエラーにならずTCP通信にフォールバックし、速度が大幅に低下する課題もあった。今回公開されたDLCは、AWSが一連のソフトウェアスタックを統合して検証やパッチ適用を行い、Amazon ECR Publicを通じて提供するため、利用者は独自のイメージ構築を行うことなく学習基盤を展開できる。
公開された手順では、2台のg6.12xlargeインスタンス(計8基のNVIDIA L4 GPU)と1台のCPUシステムノード(m7i.xlarge)でEKSクラスタを構成し、言語モデル「Qwen2.5-1.5B」をPyTorchのFSDP(Fully Sharded Data Parallel)を用いて追加学習する例が紹介された。同イメージは起動時にホストのNVIDIAドライバを確認して互換ライブラリを自動適用する仕組みを備え、単一のイメージタグで管理ノードと計算ノードの双方を兼ねることができる。この検証環境の運用費用は1時間あたり約9.50ドルとされている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
