AWS、画像や文書を読み取るNVIDIAの最新AIを動かす構成手順を公開
- NVIDIAのマルチモーダルAI「Nemotron 3.5 Super VL」をAWSの基盤で動かす手順が公開された。
- 1200億パラメータのうち毎度120億を動かす設計で、画像や動画、文書の読み取りと推論に対応する。
- Amazon EKSや高速通信を使い、処理負荷に応じた分散配置や性能測定を行う手法が示された。
AWS上でのNemotronモデル展開手法を公開
アマゾン ウェブ サービス(AWS)は2026年10月29日、NVIDIAのオープンなマルチモーダルモデル「NVIDIA Nemotron 3.5 Super VL」を、コンテナ管理サービス「Amazon Elastic Kubernetes Service(Amazon EKS)」や「Amazon SageMaker HyperPod EKS」上で運用・展開するリファレンス実装を公開した。
Nemotron 3.5 Super VLは、すでにAWSで利用可能なNemotron 3 Nano、Nano Omni、Super、Ultra、Nemotron 3.5 Lightningに加わるモデルである。「Nemotron 3 Ultra」から蒸留された学習を通じてこの数値を細かく調整することで、正しい答えや予測を出せるようになります。">重み情報)が一般に公開されており、誰でも自由に利用や改良、研究ができるAIモデルのこと。">オープンモデルであり、NVIDIAは重み、学習データセット、事後学習の手順を公開している。
視覚情報と推論を両立するモデル仕様
Nemotron 3.5 Super VLは総パラメータ数が1200億(120B)でありながら、トークンごとに動作するパラメータを120億(12B)に抑えるMixture-of-Experts(MoE)構造を採用している。Mamba-2、アテンション層、専門家層を交互に配置した構成に「RADIO」ビジョンエンコーダーを組み合わせ、テキストだけでなく画像、文書、動画の理解と推論、ツール利用を1つのモデルで処理する。Mamba-2層は生成中に一定サイズの内部状態を維持するため、系列長が伸びてもメモリ消費が抑えられる。また、Multi-Token Prediction(MTP)ヘッドを搭載し、推論の高速化手法に対応する。
NVIDIAが公表したベンチマーク結果によると、「Hermes Bench」で63.44%、「LangChain」エージェント評価で87.05%、「CharXiv」チャート推論評価で80.8%を記録した。コード検証や修正提案、ウェブ調査、表や図を含む文書要約、サイバーセキュリティの脅威分析、動画検索といった作業での活用が想定されている。
分散配置と性能測定のアーキテクチャ
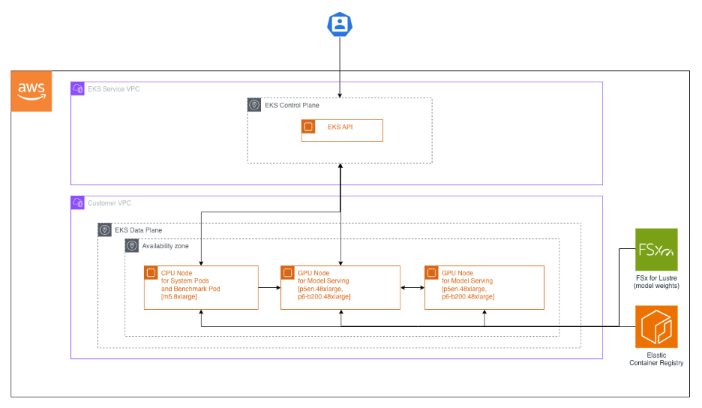
AWSが示した構成では、標準的なAmazon EKSのほか、GPUや通信機能のスケーリングを自動管理する「EKS Auto Mode」、SageMaker HyperPod EKSに対応する。コンテナイメージは「Amazon Elastic Container Registry(Amazon ECR)」、モデルの重みは「Amazon FSx for Lustre」の共有ボリュームに保存し、GPUノード間は「Elastic Fabric Adapter(EFA)」で接続する。
モデルの配信には「NVIDIA Dynamo」と「vLLM」を用い、単一ノードに集約して配信する方式と、入力処理(prefill)と生成処理(decode)を異なるノードに分離する分散方式の双方が検証された。この構成は「p6-b200.48xlarge」(NVIDIA B200を8基搭載)および「p5en.48xlarge」(NVIDIA H200を8基搭載)のインスタンスで動作確認が行われている。
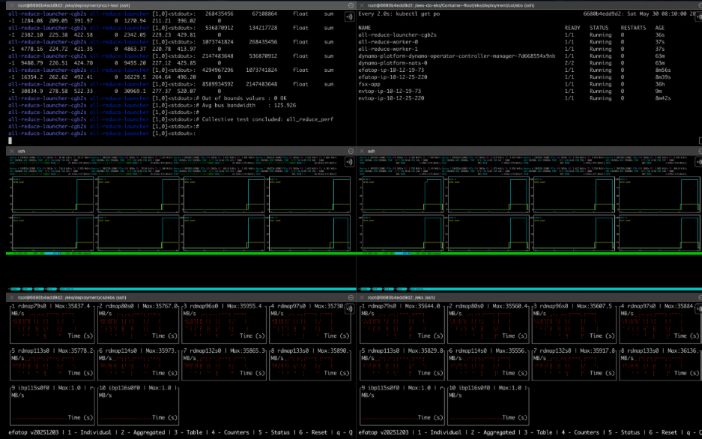
ネットワーク性能はNVIDIAのNCCLベンチマークで検証され、推論性能は「NVIDIA aiperf」ツールを用いて最初の出力までの時間(TTFT)やトークン間遅延(ITL)、秒間トークン処理数(TPS)を測定する。AWSはリクエスト並行度を変えた検証結果を示し、遅延目標に応じた構成の選定手法を解説している。詳細な構築手順は「aws-do-eks」プロジェクトで提供されており、AWSは実践的なワークショップの開催も予定している。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
