AWS、AI検索の精度向上に向けWeb収集ツール「Crawl4AI」との連携手法を公開
- AWSは、Bedrockのデータ検索機能向けに、オープンソースの収集ツール「Crawl4AI」を使う連携手法を公開した。
- 不要なメニューなどを除いたMarkdown形式と付加情報をS3へ保存し、検索用データの品質を高める仕組み。
- 自動実行にはAWS Fargateなどを利用し、定期的に最新のWeb情報を抽出して取り込むことができる。
アマゾン ウェブ サービス(AWS)は、生成AIサービス「Amazon Bedrock」の検索拡張生成(RAG)機能である「Amazon Bedrock Knowledge Bases」において、オープンソースのPython製クローラー「Crawl4AI」を活用したWebデータ前処理の連携手法とサンプル実装を公開した。
Bedrock Knowledge Basesには標準でWebクローラーコネクタが備わっているが、サイト共通のナビゲーションや定型文の混入を防いだり、独自のメタデータを付与したりするには制約があった。RAGアプリケーションの回答精度は取り込むデータの品質に依存するため、特定領域のみの抽出や構造化といった高度な前処理が求められていた。
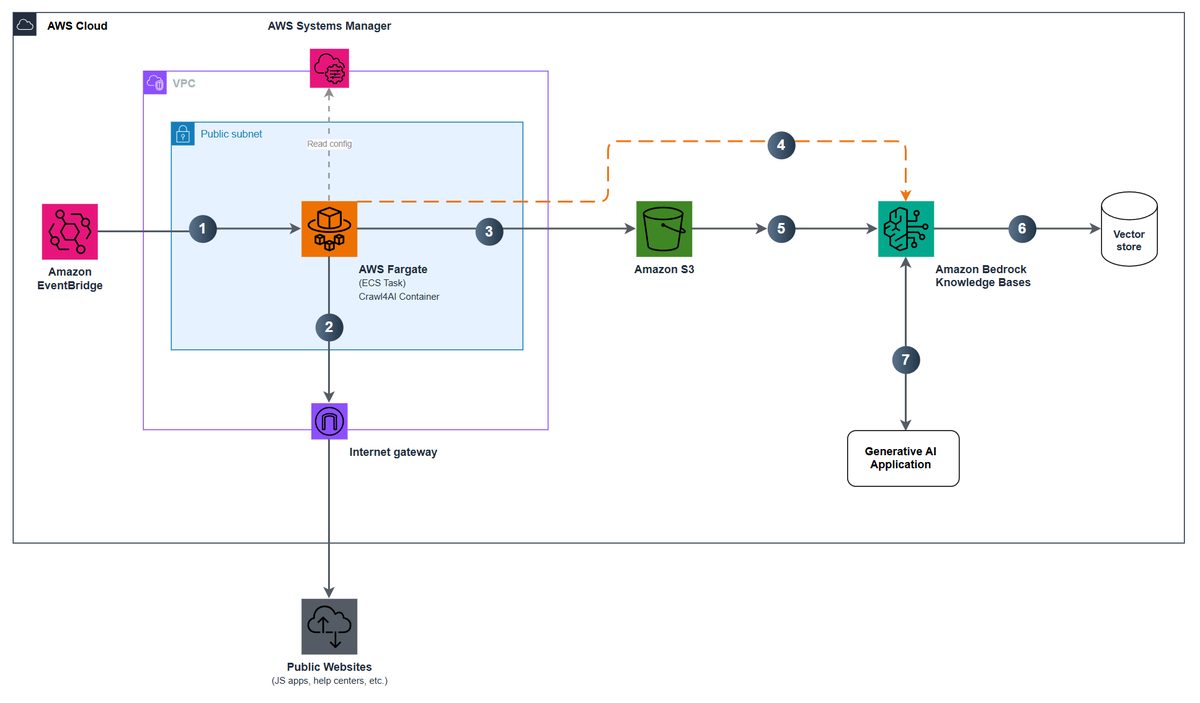
今回公開された手法では、Crawl4AIのフィルターを用いてWebページから不要な要素を削ぎ落とし、見出しや表の構造を維持したMarkdownファイルを生成する。同時に、元のURLや収集日時などの属性をまとめたJSON形式のメタデータサイドカーを作成し、Amazon S3へ保存する。Amazon Bedrockの仕様に合わせ、メタデータサイドカーのサイズは1ファイルあたり最大10KBに制限される。その後、Bedrock Knowledge Basesのデータ取り込みジョブを呼び出し、標準設定である300トークン(20パーセント重複)などのチャンキング処理を経てベクトル)に変換し、意味の近さをもとに情報を探す技術。キーワードが完全に一致しなくても、文脈やニュアンスが似ているデータを見つけ出せる。">ベクトル検索の索引に登録する。
このワークフローはAWS Fargate上のタスクとしてコンテナで動作し、Amazon EventBridgeのスケジュール機能によって定期実行される。展開にはAWS Cloud Development Kit(AWS CDK)を利用でき、自社のWebコンテンツを最新の状態に保ちながら高精度な検索基盤へ安全に反映できる構成となっている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
