高性能AIの思考を小型AIに写し取り運用費を激減 米AWSが手法を公開
- 大型モデルによる自律AIは複数回の呼び出しで費用が嵩むため、小型モデルへの知識蒸留が有効策となる。
- 教師AIの出力テキストから成功した行動履歴だけを選別し、小型AIを学習させる系列レベルの手法を解説した。
- 大型モデルの推論を小型モデルへ移植し、SageMaker AI上で効率的に学習・運用する手順を示した。
米アマゾン・ウェブ・サービス(AWS)は、自律型AIエージェントの運用コストを削減するため、大規模な「教師モデル」の行動を小規模な「生徒モデル」に学習させる知識蒸留の手法を公式ブログで解説した。クラウド機械学習基盤「Amazon SageMaker AI」を用い、推論品質を保ちながら安価かつ高速にエージェントを動かす実践的な手順を提示している。
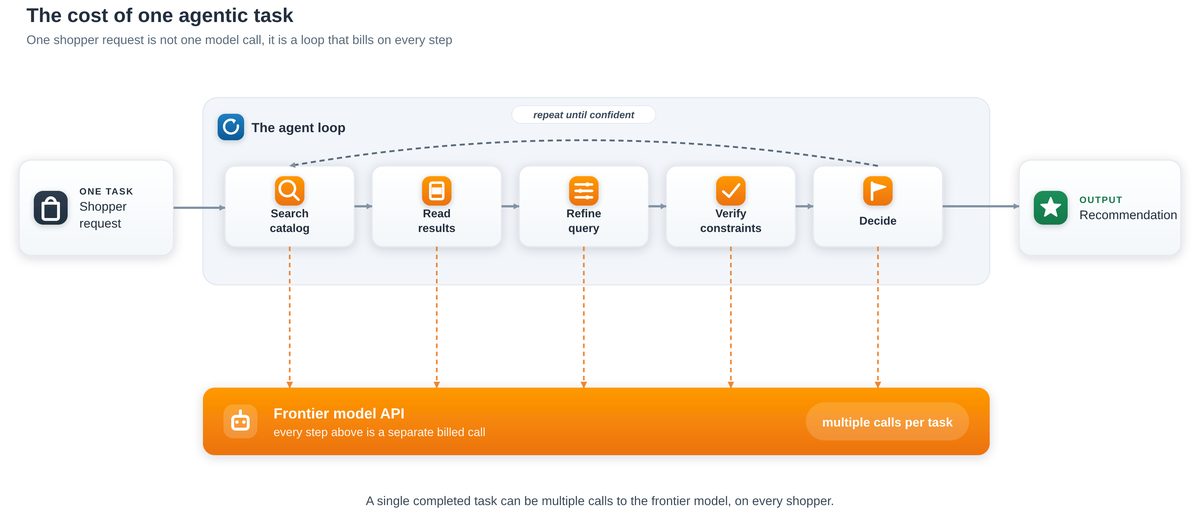
外部ツールを呼び出しながら思考と行動を繰り返すAIエージェントは、1つの作業を完結するまでに基盤モデルを何度も呼び出すため、本番環境での利用費用が膨らみやすい課題がある。一方で小規模なモデルは運用費を抑えられるものの、複雑な推論や判断で性能が不足しやすい。過去に「DeepSeek-R1」の推論プロセスを小型モデルへ移植した事例のように、大型モデルの推論手順を模倣させる手法が解決策として注目されている。
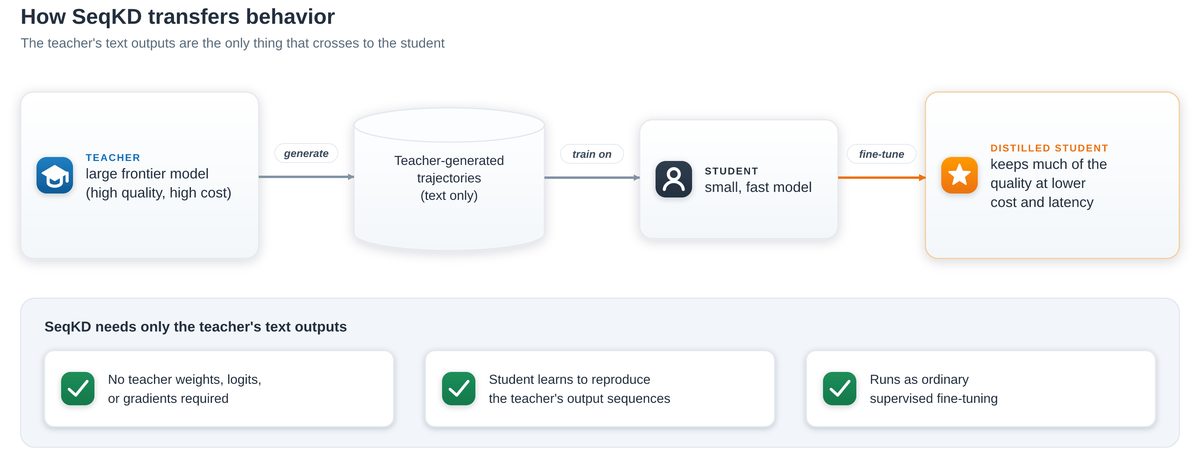
今回紹介されたのは、モデル内部の数値(ロジット)に依存せず、生成されたテキスト出力のみを用いる「系列レベル知識蒸留(SeqKD)」だ。API経由でしか利用できない閉じた大型モデルでも適用できる利点がある。具体的には、教師モデルにタスクを実行させて一連の推論やツールの呼び出しログを収集し、自動採点ツールで課題を正しく解決できた成功データのみを選別(拒絶サンプリング)して生徒モデルの学習データを作成する。
検証環境では、約270万点の商品カタログを対象にしたベンチマーク「ShoppingBench」の750問を利用した。教師役のモデル「GLM-5.3」に探索を行わせて成功した軌跡から約2,600行の学習データを抽出し、小型モデル「Qwen3.5-4B」をSageMaker AIのサーバーレス環境で追加学習させている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
