Together AI、AIの応答処理を自動で最大2.6倍に速くする新技術を発表
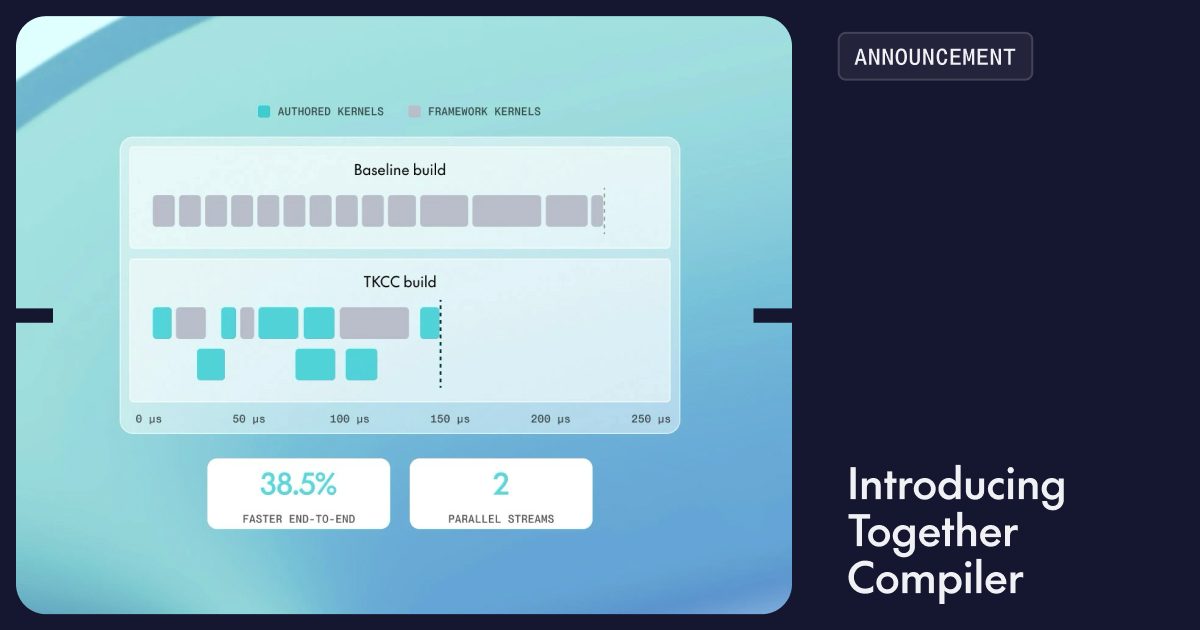
- Together AIは、AI推論をエージェント群が自動で最適化する「Together Compiler」を発表した。
- エンジンを再起動せず検証できる仕組みを導入し、最適化に必要な実験の処理効率を従来の252倍に高めた。
- 最新モデルでの検証で処理速度を最大2.6倍に向上させ、科学計算など言語モデル以外の領域にも対応する。
米Together AIは、AIモデルの推論処理を自動で継続的に最適化するシステム「Together Compiler(TKCC)」を発表した。自律的に試行錯誤を行うエージェントを活用し、トラフィックの変動やモデル、利用ハードウェアの組み合わせに合わせて最適な実行コードを生成する。同社によると、最新のオープンソースモデルを用いた評価において、24時間未満の探索で処理速度(1秒あたりの処理トークン数)を最大2.6倍に向上させたという。
手作業による最適化の限界とエージェント活用の課題
AI推論の現場では、モデル構造や計算基盤、トラフィックの特性が急速に多様化している。Transformerの登場から約11年が経過した現在でも、OpenRouterにおける上位10種類のオープンソース大規模言語モデル(LLM)の構造はすべて異なっており、ハードウェア側もH100やB200、NVL72、Groqなど多岐にわたる。これらを手作業で個別に最適化することは困難になりつつあった。
最適化の自動探索にはエージェントの活用が期待されていたが、従来のシステムはエンジンの起動と停止に数十分を要し、実験速度の遅さがボトルネックとなっていた。また、カーネル単体を孤立させてランダムな入力で評価する手法では、実データの分布を反映できず最適化の精度が落ちる問題があった。
停止なしで検証を重ねる「パーシステントエンジン」
TKCCはこうした課題を解決するため、エンジンを1度起動した後は再起動せずにフォワードパスの候補を随時反映できる「パーシステントエンジン」を採用した。複数のエージェントが掲示板を介してアイデアを共有しながら並行して探索を進めることで、従来の最適化システムと比較して実験スループットを252倍に引き上げた。
さらに、少数の層のみを読み込んで高速に評価するエンジンと、多数の層を読み込んで実データの分布に対する耐性を測るエンジンを階層化して運用する。ハードウェアの仕様や小規模なベンチマーク測定を組み合わせた独自のコストモデルを備え、並列化戦略の探索空間を迅速に絞り込む。
業界ベンチマークで最高水準を達成
評価試験では、SemiAnalysisの「InferenceX」ベンチマークにおいて、低遅延環境下で「MiniMax M3.1-Flash」が1秒あたり1111トークン、「DeepSeek v4.1-Flash」が同1205トークンを記録し、最高水準の性能を示した。また、手動でチューニングされたLlama 1Bの環境に対しても1.7倍の速度を達成している。
同技術は言語モデルにとどまらず、気象予測や偏微分方程式の解析、時系列データ処理、生物学モデルなど多様なAI基盤コードにも適用可能で、汎用的な最適化手法として機能することが確認されている。
この記事は Together AI 公式の発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
