米YCのCEO、複数AIで記憶を共有する基盤「GBrain」公開 自身も15万件で運用
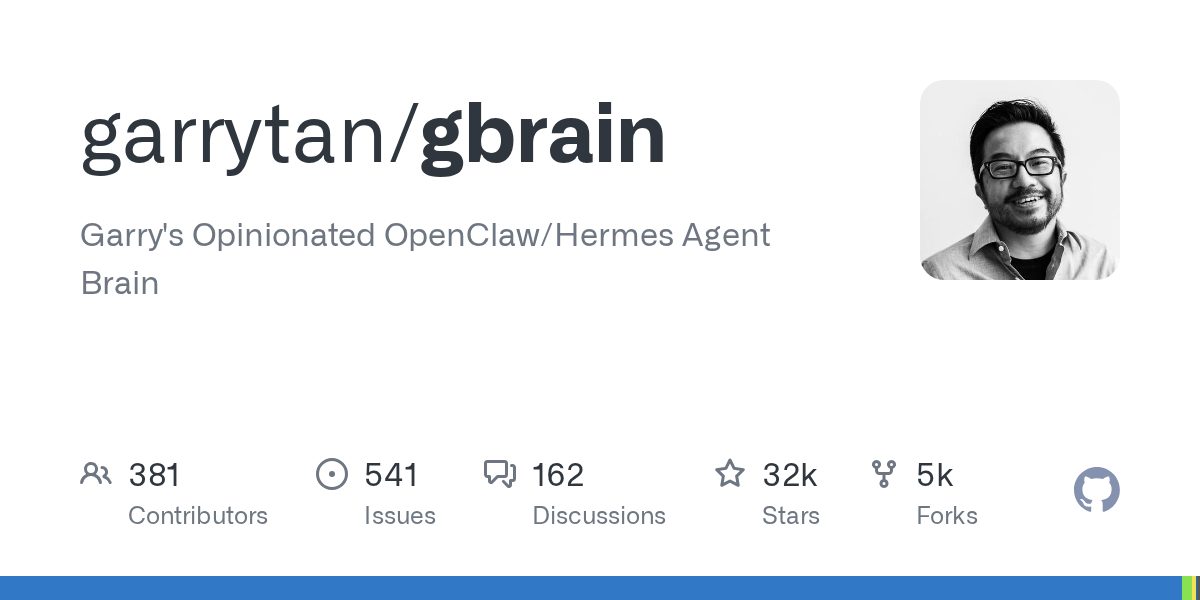
- 米YCのギャリー・タンCEOが、AIエージェントの記憶を管理・共有する基盤「GBrain」を無償公開した。
- タン氏自身が15万ページ以上のデータ蓄積に実用しており、出典付き回答の生成や自律的な記憶更新を行う。
- MITライセンスのオープンソースとして提供され、ClaudeやChatGPTなど多様なAIツールと連携できる。
米スタートアップ育成組織Y Combinator(YC)の社長兼CEOであるGarry Tan(ギャリー・タン)氏は、複数のAIエージェント間で一元的な記憶を管理・共有できるオープンソースソフトウェア「GBrain」を公開した。MITライセンスに基づく無償のクラウド事業者のサービスを使わず、自社が管理するサーバーやパソコン内にAIモデルやシステムを導入して運用すること。情報漏洩を防ぎたい場合や通信費を抑えたい">セルフホスト版として提供されるほか、導入を容易にするホスティング版「gbrain.io」も用意されている。
GBrainは、AIエージェントが収集した事実を出典情報とともに明示的に記録し、情報の訂正や取り下げ、複数エージェント間での記憶の横断利用を可能にするシステムである。従来の検索ツールのように関連文書の断片を一覧表示するだけでなく、収集した知識を統合して出典付きの回答を生成する機能や、蓄積データの中で何が不足しているかを明示する分析機能を備える。これにより、事前の情報収集や会議の準備といった作業をエージェント側で完結させられるという。
開発の経緯として、Tan氏自身が自らのAIエージェント環境(OpenClawやHermes)を稼働させるために構築した背景がある。同氏の運用環境では、15万5795ページ、2万4589人、5340社に及ぶ情報が蓄積され、66個の定期実行ジョブが自律的に稼働している。就寝中に会議ログやメール、音声通話、着想などを取り込み、人物や企業に関する情報を補完しつつ、引用の修正や記憶の統合を一晩で行う構成をとる。Tan氏は「15万ページの頭脳を構築する意義は文脈を決して失わない戦略的な強みとすることにある」と述べている。
技術面では、ベクトル)に変換し、意味の近さをもとに情報を探す技術。キーワードが完全に一致しなくても、文脈やニュアンスが似ているデータを見つけ出せる。">ベクトル検索とキーワード検索を組み合わせたハイブリッド検索に加え、型付きナレッジグラフをサポートする。ベンチマーク「BrainBench」の関係性に関する質問テストでは、関係性検索の導入によって本番環境の検索指標「R@5」が0.6626から0.7241へと向上した実績が示されている。また、オープンな通信規格であるMCP(Model Context Protocol)に対応し、Tailscaleのネットワークを経由してローカル端末の記憶基盤をクラウド上のエージェントへ安全に公開できる。
連携先としてはClaude CodeやCodex、ChatGPT、Cursorなど主要な開発・対話ツールが対象となる。セットアップにはJavaScriptランタイム「Bun 1.4.4」以降が必要とされ、24時間稼働の常時取り込み環境には8GB以上のRAMを持つサーバーが推奨されている。なお、npm上で配布されている同名パッケージは無関係であるため、GitHubリポジトリから直接導入するよう案内されている。
この記事は GitHub トレンドの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く