AWS、AIが文章を作らず「最適な選択肢」を数値で判定する仕組みを公開
- AWSが機械学習基盤上でllama.cppを活用し、判断処理に特化したモデルを運用する手法を公開した。
- 文章生成を省いて選択肢の確率を直接出力する拡張機能により、業務の振り分けや行動選択を効率化する。
- 231件の検証でGPU構成はCPUに比べ応答速度が最大32.2倍向上し、高い処理性能を示した。
アマゾン・ウェブ・サービス(AWS)は、同社の機械学習プラットフォーム「Amazon SageMaker AI」において、軽量な推論環境「llama.cpp」を用いて意思決定モデルを運用する構成を発表した。問い合わせの振り分けや自律型エージェントの行動選択、規約判定といった用途では、AIによる自由な文章生成ではなく、あらかじめ定められた選択肢に対する評価値が求められるケースが多い。今回の手法は、量子化された小型モデルをCPUやGPU上で効率的に運用し、構造化された判断結果を直接取得する環境を提供する。
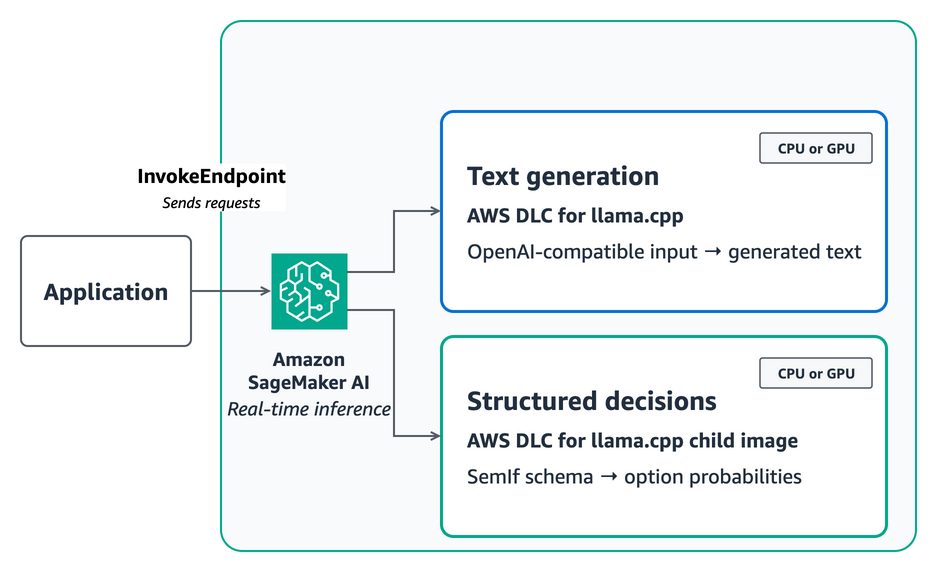
本構成は、生成AIの推論に特化したコンテナ群「AWS Deep Learning Containers(DLC)」を活用したシリーズの一環である。これまでにWhisperXやvLLM-Omniを取り上げた検証に続く取り組みとなる。システム構成としては、OpenAI互換のチャット形式でテキストを生成する標準パスと、「SemIf」(旧称OpenJev)と呼ばれるアダプターを組み込んだ構造化決定パスの2系統が提示された。
SemIfを利用したパスでは、回答となる単語を1文字ずつ生成する処理を行わず、提示された選択肢ごとの確率やロジットを直接取得する。入力データとしてリクエストID、文脈情報、質問、許可された選択肢の一覧を渡すと、各選択肢の確率と識別子が元の順序のまま返却される。固定の識別子と数値が直接得られるため、開発側はAIが生成した文章を解析することなく、しきい値の判定や例外処理、社内ルールの適用といった後続処理を安定して実行できる。
公開ベンチマーク「JevBench」の231件のタスクを用いた検証では、CPU構成とGPU構成の処理速度が比較された。その結果、GPUエンドポイントはCPU構成に比べ、応答速度の中央値(p50)で4.9倍、95パーセンタイル(p95)では32.2倍の高速化を達成した。検証環境のインスタンス「ml.g6e.xlarge」では、対象モデルの全34レイヤーがNVIDIA L40Sへオフロードされたことが確認されている。
モデルの規模別の比較においては、パラメータ数が20億(2B)の候補で66.7パーセント、8億(0.8B)の候補で58.4パーセントの精度にとどまったことから、提供されたサンプルでは判定精度を重視して40億(4B)の量子化形式「Q4_K_M」が標準構成に選定されている。AWSは、遅延を許容できるバッチ処理にはCPUを、対話的な判断や長文の文脈を扱う用途にはGPUの採用を推奨している。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
