アマゾンのAI基盤で「Grok 4.7」提供開始、じっくり考える度合いを調整可能に
- アマゾンがクラウド基盤「Amazon Bedrock」でSpaceXAIの「Grok 4.7」を提供開始した。
- 思考の深さを4段階で設定でき、複雑な検証タスクの実験では最高レベルで18回中全問正解を記録した。
- 最低レベルでは消費量を約8分の1に抑えつつ18回中15回正解し、コストと精度の調整が可能になった。
米アマゾン・ウェブ・サービス(AWS)は、同社の生成AI基盤「Amazon Bedrock」において、SpaceXAIが開発した最新モデル「Grok 4.7」の提供を開始した。Grok 4.7は、自律的に作業を進めるAIエージェント向けに設計されており、自らの作業結果を検証しながら多段階の困難な課題を遂行できる能力を備える。Amazon Bedrock上では、回答前にどの程度深く思考するかを制御する設定項目が用意されている。
SpaceXAIによると、Grok 4.7は前身の「Grok 4.6」よりも大規模な学習済みAIモデルのこと。あらかじめ膨大なデータを学んでおり、様々な応用作業の基礎として活用されます。">ベースモデルを採用し、完了までに何時間も要する難度の高い課題に重点を置いた強化学習が施されている。これにより、長文の文脈管理や自己検証の精度が向上した。コンテキストウィンドウは50万(500K)トークンに対応し、テキストと画像の入力、およびテキストの出力が可能となっている。
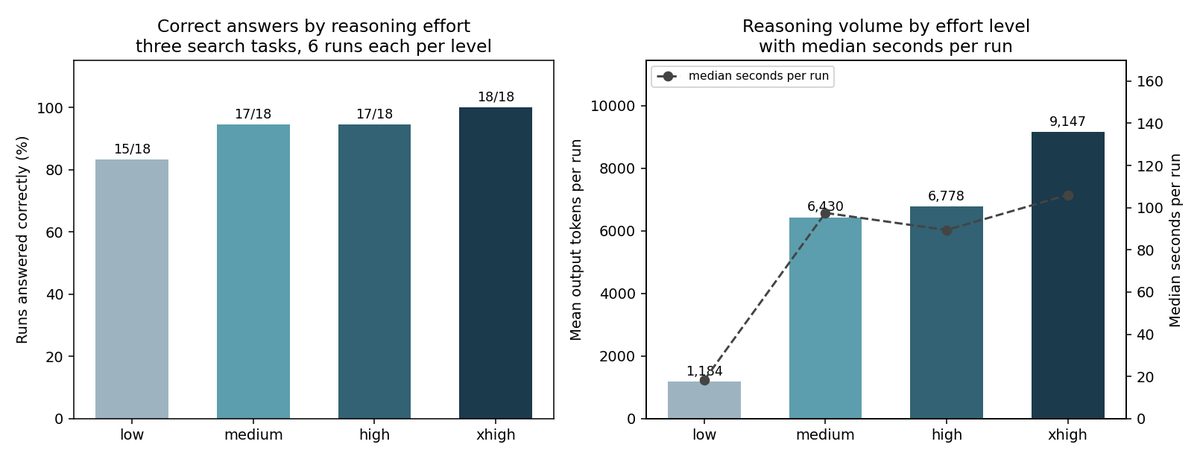
AWSは、単純な検索では解けず探索と検証が不可欠な3つのタスクを用意し、思考レベルの設定がエージェントの性能に与える影響を検証した。2つのサービス障害の診断、制約条件下での保守計画、予算内での移行先の選定という3種類の課題に対し、思考レベルを「low」「medium」「high」「xhigh」の4段階に切り替え、各設定で6回ずつ、合計72回のエージェント実行を実施した。
検証の結果、エージェントは72回中67回で正解を出力した。最高レベルの「xhigh」では18回すべての試行で正解を達成し、「medium」と「high」もそれぞれ18回中17回正解した。一方、最低レベルの「low」でも18回中15回正解し、出力トークン数は「xhigh」の約8分の1(平均1,184トークン対9,147トークン)にとどまった。ツールを呼び出す回数はどのレベルでも1回あたり17.2回から18.7回とほぼ横ばいであり、思考レベルの設定は外部情報の探索量ではなく、集めた情報に対する思考の深さに影響を与えることが確認された。
Amazon Bedrock上のGrok 4.7は、複数リージョンにトラフィックを分散してスループットを向上させるクロスリージョン推論プロファイル経由で呼び出す仕様となっている。思考プロセスで使用されるトークンは出力トークンとして消費されるため、AWSは上限設定に余裕を持たせることや、タスクの難易度に応じてリクエスト単位で思考レベルを調整する運用を推奨している。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く