AWSが巨大AIの推論処理を高速化、応答の待ち時間を最大9%短縮
- AWSは、複数構造を持つ巨大AIの計算処理を効率化し、応答の待ち時間を最大9%短縮したと発表した。
- 最新半導体の仕様に合わせて計算配置を反転させ、空き時間を減らすことで処理能力を最大4%高めた。
- 内部処理の統合や再コンパイル停止をオープン基盤vLLMへ反映し、自社の機械学習基盤にも導入した。
アマゾン ウェブ サービス(AWS)は、Amazon SageMaker AIにおいて、専門家モデルを組み合わせる「Mixture-of-Experts(MoE)」アーキテクチャの学習済みのAIが実際に答えを出す処理。使うたびに計算コストがかかる。">推論計算を最適化するカーネル技術を開発したと発表した。オープンソースの推論エンジン「vLLM」と連携して複数の最適化を実装した結果、NVIDIAのGPU「H200」環境において、推論スループットを最大10%向上させ、最初の応答が出力されるまでの時間(TTFT)を最大9%短縮した。
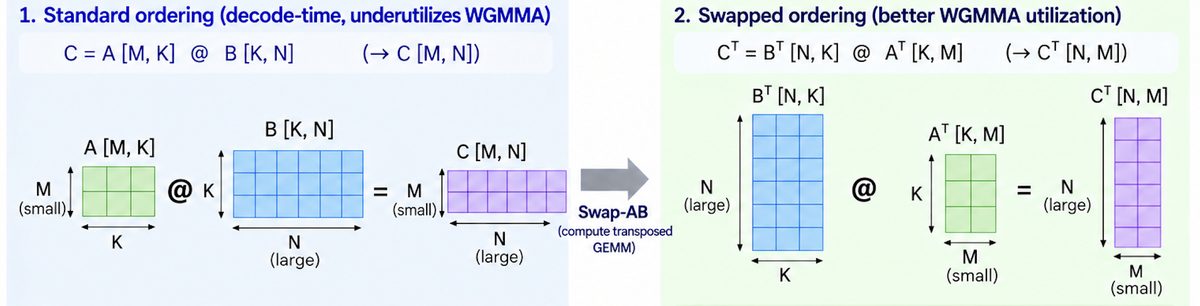
MoEは計算量を抑えつつモデル規模を拡大できる構造だが、推論処理の大半を専門家ネットワークの計算が占めるため、ここでの非効率性が遅延やコストの上昇に直結していた。特にNVIDIA Hopper世代のGPUでは、128スレッドが協調して動作する命令プロトコル(WGMMA)のハードウェア仕様上、第1オペランドの行方向の寸法(M)が64以上に固定される制約がある。しかし、推論のデコード段階では1トークンずつ処理するためMが1や64未満と極めて小さくなり、ハードウェアの計算資源を埋められずTensor Coreが遊休状態に陥る課題を抱えていた。
AWSの開発チームはこの不整合を解消するため、行列計算の入力をプログラム上で転置する手法を導入した。専門家層の巨大な重みブロックを先頭スロットに配置することで、ハードウェアが求める64行の要件を満たし、計算密度を高めるとともに非同期データ先読み(プリフェッチ)を有効化させた。この最適化により、H200上の大規模MoEモデルでエンドツーエンドのスループットが2〜4%向上した。この成果はvLLMバージョン0.24.0以降に取り込まれている。
さらに、FP8量子化モデルを処理するバックエンドの選定も見直した。従来採用されていたCUTLASSによる処理は、FP8のスケーリングや行列積を個別の処理として実行するためメモリとの往復負荷が生じていた。これをTritonバックエンドに切り替え、データを高帯域メモリから1度読み出すだけでGPU内部のレジスタ内で完結させる統合処理へ変更した。カーネルコードを変更せずルーティング設定を更新しただけで、H200におけるスループットが10%向上し、AWSの深層学習コンテナ「LMI v28」に反映された。
加えて、Tritonコンパイラが整数引数を固定値として扱う性質に起因する、実行時のJIT再コンパイル問題も解消した。トークン数が変動するたびに再コンパイルが走り、8基のGPUを並列稼働させる環境で他のGPUが待機させられる状態が生じていた。可変パラメータに再コンパイルを防ぐ記述を追加したことで待機時間をなくし、TTFTを9%改善させた。この修正もvLLMバージョン0.22.0以降に反映されている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
