AWSのAI半導体でモデル開発が手軽に 主要AIの89%がそのまま動く新基盤を公開
- Hugging FaceがAWSのAI半導体Trainiumに対応する新基盤TorchNeuronを発表した。
- PyTorchに直接統合され、主要テキスト生成モデルの89%が標準コードのまま利用可能になる。
- 2026年10月20日より公開ベータを開始し、従来の専用変換ツールを介さず標準機能で動作する。
オープンソース学習、運用を支えるために必要な高性能な計算用コンピューターやデータセンター、通信ネットワークなどの基盤設備のこと。">AI基盤を手がけるHugging Faceは2026年10月19日、アマゾン・ウェブ・サービス(AWS)のAI専用半導体「AWS Trainium」に対応したPyTorch向け新バックエンド「TorchNeuron」を発表した。2026年10月20日よりパブリックベータとして提供が開始され、開発者は「pip install torch-neuronx」を通じて導入できるようになる。
これまでAWS TrainiumやAWS Inferentia上でHugging Faceのライブラリを実行する際は、PyTorch XLAをベースにした「optimum-neuron」ライブラリを経由する必要があった。従来の環境では遅延評価や入力形状の固定、グラフ分割による再コンパイルなどコンパイラ特有の制約を意識する必要があり、複雑さを隠蔽するために専用のモデリングクラスや学習プログラムなどの独自コードを保守しなければならなかった。
新バックエンドのTorchNeuronはPyTorchに直接統合され、Neuronをネイティブな演算デバイスとして認識させる。これにより、逐次実行(eager mode)やtorch.compile、FSDP2やDTensorなどのPyTorch標準の分散処理機能が利用可能になる。Transformers、Diffusers、Accelerate、PEFT、TRLといった主要ライブラリが、他の一般的なハードウェアと同じスクリプトやクラスのまま動作するようになり、同社は従来のOptimum Neuron経由ではなく標準ライブラリの直接利用を推奨している。
モデルの互換性も大幅に高まった。最も利用頻度の高いテキスト生成モデル上位100の構造のうち、追加の改修なしで動作するモデルの割合は、Optimum Neuron v0.4.5の46%から89%に向上した。コード内でデバイス指定に「neuron」を渡すだけでデバイスへの配置が行える。
モデル学習においては、TRLを用いた教師あり微調整(SFT)スクリプトをわずかな設定変更だけで実行可能だ。テンソル並列とFSDPを組み合わせることで大規模な分散処理に対応する。発表では、8基のTrainium2チップ(32基のNeuronCore、trn2.48xlargeインスタンスの半分に相当)を用いた検証で学習が正常に完了し、保存された重みは標準のTransformers形式として他の環境へそのまま移行できることが確認された。
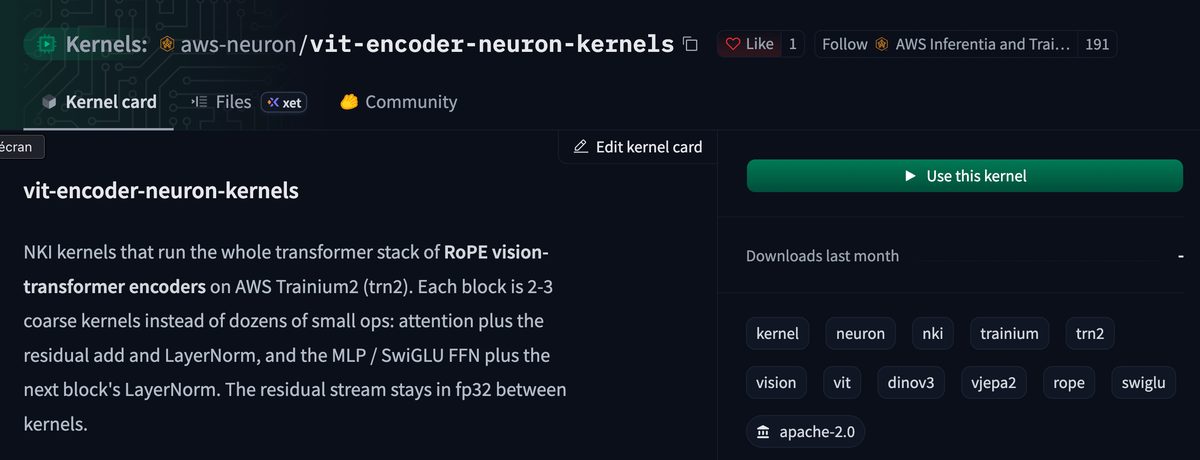
画像生成分野でもDiffusersライブラリのFLUX.1-dev、FLUX.2、Qwen-Imageなどがテンソル並列に対応する。さらにNeuron Kernel Interface(NKI)で記述された専用カーネルの提供も進められており、Vision Transformerにおいて最大2.4倍の高速化が達成された実績も示されている。
この記事は Hugging Face 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
