NVIDIA、大規模AI工場の障害を防ぐ新管理システムを発表 テスラら導入へ
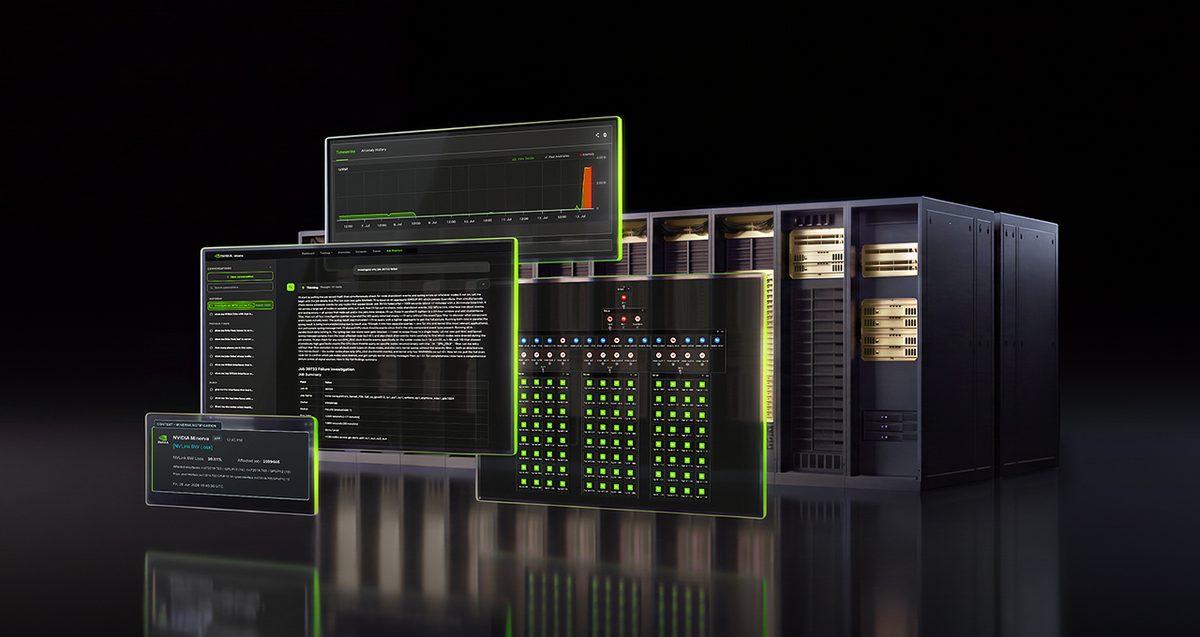
- NVIDIAは大規模なAI設備全体を監視・管理するプラットフォーム「Minerva」を発表した。
- 毎時数十億件のデータを機械学習で分析し、障害の予測や原因部品の特定を自動で行い稼働停止を防ぐ。
- 米テスラやIBMなどが導入を計画し、デルやレノボなども自社運用ツールとして提供を予定している。
米NVIDIAは、大規模な学習、運用を支えるために必要な高性能な計算用コンピューターやデータセンター、通信ネットワークなどの基盤設備のこと。">AIインフラの運用を支援するAIOpsプラットフォーム「NVIDIA Minerva」を発表した。インフラとAI処理の双方から運行データを集約し、専用のAIモデルを用いて障害の予兆検知や迅速な対処を可能にする仕組みを提供する。
AIの大規模設備では、多数のGPUが高速ネットワークを介して稼働しており、部品1つの性能低下が計算作業全体の遅れを引き起こす課題がある。MinervaはGPU、ネットワーク、ストレージなどの稼働状況を統合し、インフラと実行中の作業を論理的に対応づけた動的ナレッジグラフを構築する。これにより、数十万基規模のGPU設備であっても、処理遅延を引き起こしている具体的な構成要素を特定できる。
システムは教師あり学習および教師なし学習を用い、毎時数十億件のデータポイントを分析する。正常な状態を学習したうえで異常や潜在的な故障を予測し、大量のアラートを根本原因ごとに集約する。さらに自然言語でクラスタの状態を対話確認できるAIアシスタント機能も備え、推奨される復旧手順の提示や自動化システムとの連携にも対応する。
すでにIRENが最適化に向けて採用しているほか、Tesla、IBM、Lambda、Bitdeer AI、Aolani、Quake AI、Jioが導入を計画している。IRENの最高技術責任者(CTO)であるDenis Skrinnikoff氏は「ネットワーク、GPU、ジョブを横断した単一の視野が得られ、問題発生後の対処から予防的な保守へ重点を移せる」と述べている。Dell Technologies、Lenovo、Supermicroも運用ポートフォリオの一部としてMinervaを提供する方針だ。
この記事は NVIDIA 公式ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
