AWS、AIの追加学習をGPU管理なしで実行できる新機能を正式提供
- AWSは、GPU管理不要でモデルの事後学習を行える新機能「トレーニングセッション」の一般提供を開始した。
- 強化学習や損失関数をユーザー自身で制御でき、課金は処理トークン単位で採点待機中は課金が停止する仕様だ。
- gpt-oss-20bやQwen3.6-27Bなどに対応し、開発環境は20秒未満で立ち上げ可能となっている。
アマゾン ウェブ サービス(AWS)は2026年10月22日、基盤モデルの学習済みのAIに自社データなどを追加で学ばせて、特定の用途に合わせて調整すること。">追加学習向け機能「Amazon SageMaker AI serverless model customization」を拡張し、「トレーニングセッション(training sessions)」の一般提供を開始したと発表した。開発者は基盤となるGPUインフラストラクチャを自ら管理することなく、事後学習のロジックや強化学習のループを柔軟に制御できるようになる。
インフラ管理を排し学習ループの制御性を確保
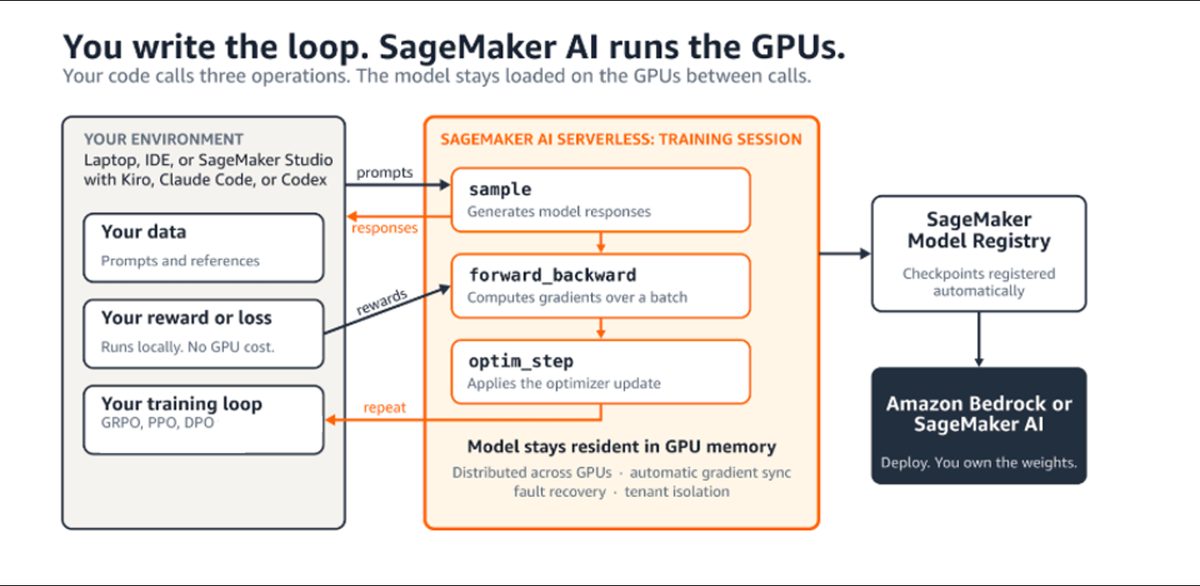
企業が業務データや専門用語に合わせてAIモデルを最適化する際、適切な学習手法の選択やGPUインフラの管理、エージェント向けマルチターン強化学習環境の構築が大きな課題となっていた。今回のトレーニングセッションでは、ユーザーがカスタム損失関数や報酬シグナルを含む学習ループを記述する一方、GPUの割り当て、分散実行、障害復旧、チェックポイントの保存といったインフラ運用処理はAmazon SageMaker AIが担当する。
対応する手法は、教師あり微調整(SFT)や直接選好最適化(DPO)のほか、強化学習手法のRLVR、RLAIF、マルチターン強化学習など多岐にわたる。パラメータ更新手法としても、Low-Rank Adaptation(LoRA)とフルファインチューニングの双方が選択可能だ。
医療分野向けソリューションを手がける米ImagineSoftwareのデータサイエンス担当シニアバイスプレジデント、Rob Gontarek氏は「医療保険の請求却下トリアージモデルの構築に採用した。順伝播や逆伝播、サンプリング、最適化ステップを直接制御できるため、高い精度が求められる強化学習を本番水準まで進めることができた」と評価を寄せている。
独自の強化学習アルゴリズムや評価環境を接続可能
トレーニングセッションでは、ユーザー側の環境で実行するコードがサンプラーやトレーナーと連携して動作する。例えば強化学習手法のGRPO(Group Relative Policy Optimization)を用いる場合、サンプラーが生成した複数応答を自前の検証器などで採点し、そのスコアをトレーナーに返して勾配計算と重み更新(forward_backwardおよびoptim_step)を実行する流れを反復できる。
料金はSageMaker AIが処理したトークン数に応じて発生し、ユーザーの環境で報酬関数がバッチを採点している間は課金メーターが停止する。計算資源の事前確保は不要だ。セキュリティ面では、AWS Identity and Access Management(IAM)の実行ロール、AWS Key Management Service(AWS KMS)の暗号鍵、Virtual Private Cloud(VPC)構成を適用できる。データやチェックポイントは指定したリージョンのAmazon S3バケット内に保持され、他社向けモデルの学習に利用されることはない。
提供開始時点でサポートされるモデルは、gpt-oss-20b、gemma-4-31B-it、Qwen3.6-27B、Qwen3.8-27Bの4種類である。SageMaker Python SDK(LinuxまたはmacOS、Python 3.10〜3.12に対応)経由で利用できるほか、SageMaker Studioでは20秒未満で立ち上がる開発環境からノートブックを開いて利用を開始できる。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
