AWS、大規模AIを2台の計算機に分担させて高速処理する新基盤を公開
- AWSが複数ノード環境向け「Ray LLM Deep Learning Containers」を公開した。
- AIの質問読み込みと回答生成を別々のGPUに分離し、処理の遅延を防ぐ仕組みを整える。
- 推論エンジンや通信ライブラリを事前検証済みで同梱し、設定ファイルのみで構築できる。
アマゾン・ウェブ・サービス(AWS)は、大規模言語モデル(LLM)を複数のGPU搭載ノードに分散して実行するための環境「Ray LLM Deep Learning Containers(DLC)」を公開した。Amazon Elastic コンテナ」という仕組みを、数百から数千台規模で自動的に配分・運用管理するためのプラットフォームです。">Kubernetes Service(EKS)上で、1つのモデルを2台のGPUノードに分散配置し、1つのOpenAI互換エンドポイント配下で協調動作させることが可能となる。
LLMの推論処理には、入力文全体を並列処理してKVキャッシュを生成する「プリフィル」と、1トークンずつ回答を生成する「デコード」の2段階がある。プリフィルは計算負荷が高く、デコードはメモリ帯域に依存するため、単一のGPUで同時に実行するとリソースを取り合い、生成速度が低下する課題があった。両フェーズを別ノードに分離することで独立したスケーリングが可能になる一方、環境ごとにGPUドライバや通信ライブラリの整合性を保つ作業が開発者の負担となっていた。
今回提供されたRay LLM DLCは、推論エンジン「vLLM」や分散処理フレームワーク「Ray Serve」、ノード間データ転送ライブラリ「NIXL」、高速通信を担うElastic Fabric Adapter(EFA)スタックを事前に組み込んで検証したコンテナイメージである。コードを直接記述することなく、YAML設定ファイルを用意するだけで、ノード間のKVキャッシュ転送を含むOpenAI互換APIを立ち上げられる。
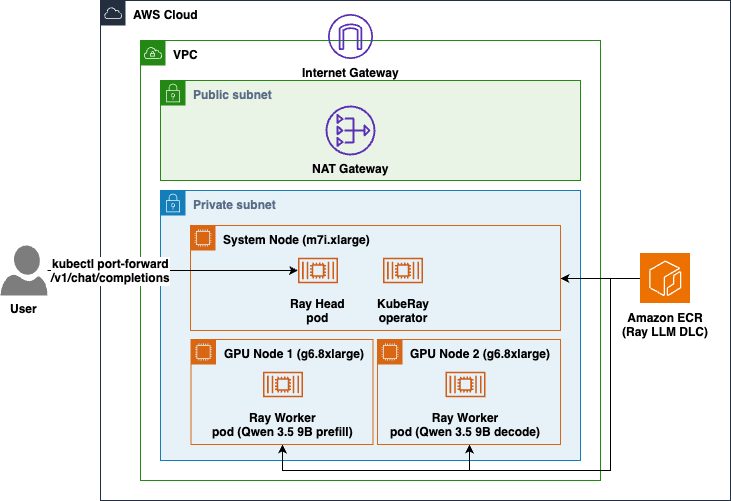
具体例として示された構成では、システム管理用のCPUノード「m7i.xlarge」1台に加え、GPUノード「g6.8xlarge」2台を使用する。各GPUノードがプリフィルとデコードを分担し、EFAを通じてキャッシュを転送する仕組みを構築した。検証例として示されたモデル「Qwen3.5-9B」の読み込みでは、キャッシュ設定を活用することで、モデルの重み読み込み時間が約145秒から再起動時には約2秒まで短縮されるとしている。
この記事は AWS 機械学習ブログの発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
