Google、手描きの絵や動画からロボットの動きを自律学習する新AIを発表
- Google DeepMindが物理世界の理解に特化したAIモデル「Gemini 4 Argon」を発表した。
- 3D空間の物理問題を解くテストで87%を記録し、手描きスケッチや動画から動作環境を自ら再現できる。
- 仮想空間で試行錯誤を重ねることで、実機ロボットの作業成功率を56%から75%へ向上させた。
米Google DeepMindは、物理世界の理解やコード生成、視覚的・意味的学習済みのAIが実際に答えを出す処理。使うたびに計算コストがかかる。">推論の能力を高めたロボティクス向けAIモデル「Gemini 4 Argon」を発表した。ロボットの設計から制御、検証に至るライフサイクル全体への適用を想定しており、物理空間で自律的に活動する汎用人工知能(AGI)の実現に向けた基盤モデルとして位置づけている。
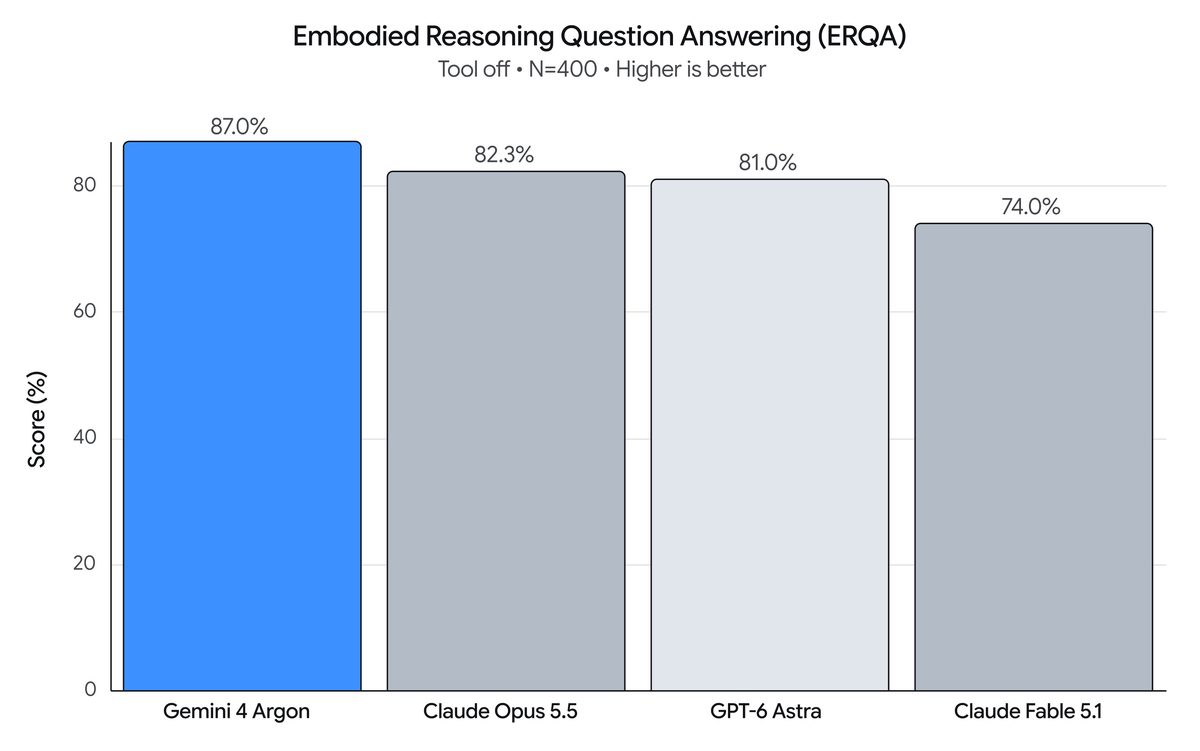
Gemini 4 Argonは、3次元環境における物理的・空間的な課題解決能力を測定するベンチマーク「Embodied Reasoning(ERQA)」において、純粋な推論のみで87%のスコアを記録した。同社によると、この数値は既存の最前線のモデルを上回る水準だという。
同モデルは、ロボット実機やシミュレータの高度な制御に対応する。米Boston Dynamicsの4足歩行ロボット「Spot」(脚部12自由度、アーム6自由度)を用いた検証では、足踏みペダル式ゴミ箱のデジタルツインを物理シミュレータ「MuJoCo」上に作成して練習させた後、実機でペダルを踏んで空き缶を捨てる動作を獲得させた。また、倒れたマグカップを起こしてナプキンを入れる作業や、散らばったタイルを整列させるタスクを視覚的なフィードバックを受けながら段階的に実行する。
現実のデータからシミュレーション環境を構築する「Real2Sim」機能も備える。人間の一人称視点動画から対象物を認識してメッシュを生成し、76自由度の全身と22自由度の5本指ハンドを持つ人型ロボットの動作へ変換できる。紙に手描きされたスケッチ画像から、放物線を描いてボールを投げ箱を倒す物理環境を自動構築し、シミュレーション検証を経てレンダリング出力する処理も可能にした。
さらに、シミュレーションを通じて実機の性能を高めるデータ生成にも利用できる。机の上のカラー写真1枚からキャリブレーション済みのシミュレータ環境を自律構築し、4,500件以上のエピソードを収集して学習させた結果、実機ロボットのタスク成功率が56%から75%に向上し、所要時間も35秒から24秒に短縮したという。このほか、ロボット工学の学術論文を読み込み、制御プログラムをブラウザ環境へ移植・検証する能力も備える。
Gemini 4 Argonは開発者向けに即日提供が開始された。「Google AI Studio」のUltra加入者やGemini APIの有料プランで利用できるほか、開発基盤「Google Antigravity」でもモデルを選択して複雑な計画立案やマルチエージェント連携に活用できる。
この記事は Google DeepMind 公式の発表を AI が日本語に要約したものです。正確な内容は原文をご確認ください。
アプリで開く
